Tietovarasto tiedon kokoajana
Tällä sivulla puhutaan tietoalustoista ja tiedon mallintamisesta. Tavoitteena on antaa yleiskuva siitä, mikä tietovarastojen rooli on tiedolla johtamisessa ja missä tilanteissa sellaisia kannattaa lähteä toteuttamaan.
Tietovarasto kokoaa eri tietolähteiden tietoja raportointia, analytiikkaa ja päätöksentekoa varten. Konepajassa siihen voidaan yhdistää esimerkiksi toiminnanohjauksen, tuotannon, laadun, kunnossapidon, talouden ja koneiden tietoja. Näin toimintaa voidaan tarkastella yhtenä kokonaisuutena yksittäisten järjestelmien sijaan.
Tietovarasto on hyödyllinen erityisesti silloin, kun tietoa täytyy yhdistää useista järjestelmistä, historiatietoa halutaan säilyttää tai mittareiden laskenta halutaan yhdenmukaistaa. Erillistä tietovarastoa ei kuitenkaan tarvita kaikkiin raportointitarpeisiin. Rajattu tarve voidaan usein ratkaista lähdejärjestelmien raportointitoiminnoilla, data-analyyseillä tai kevyellä tietokantaratkaisulla.
Tietovarastohanke kannattaa aloittaa liiketoiminnan kysymyksestä ja yhdestä rajatusta käyttötapauksesta. Ennen teknistä toteutusta määritellään käyttäjät, käsitteet, mittarit, tietolähteet, tietojen omistajat ja datan laatuvaatimukset. Ratkaisun tulee sisältää myös testaus, valvonta, käyttöoikeudet, dokumentointi ja nimetyt ylläpitovastuut.
Tietovarasto ei itsessään paranna tiedon laatua eikä muuta dataa hyödylliseksi tiedoksi. Hyöty syntyy vasta, kun luotettava data yhdistetään ymmärrettäviin mittareihin, otetaan osaksi päätöksentekoa ja sitä kehitetään todellisten käyttötarpeiden perusteella.
Tarvitseeko yrityksemme tietovaraston?
Tietovarasto (Data Warehouse, DW) on pääosin analytiikkaa ja raportointia varten rakennettu tietokokonaisuus, johon yhdistetään, yhdenmukaistetaan ja tallennetaan tietoa yhdestä tai useammasta lähteestä. Se toteutetaan tavallisesti relaatiotietokannan tai pilvipohjaisen tietoalustan avulla. Tässä yhteydessä "tietovarasto"-termiä käytetään laajassa mielessä kattamaan myös muita vastaavia tietoalustatyyppejä, kuten viime vuosina yleistyneen data lakehouse arkkitehtuurin. Erilaisista tietoalustatyypeistä löytyy kuvausta ja vertailua alempana tällä sivulla. Olennaista ei ole yksittäinen tallennusteknologia, vaan tiedon hallittu rakenne, historiatiedon käsittely ja soveltuvuus toistuviin analyyseihin.
Alla on yleistason periaatekuva selventämään tietovaraston roolia.
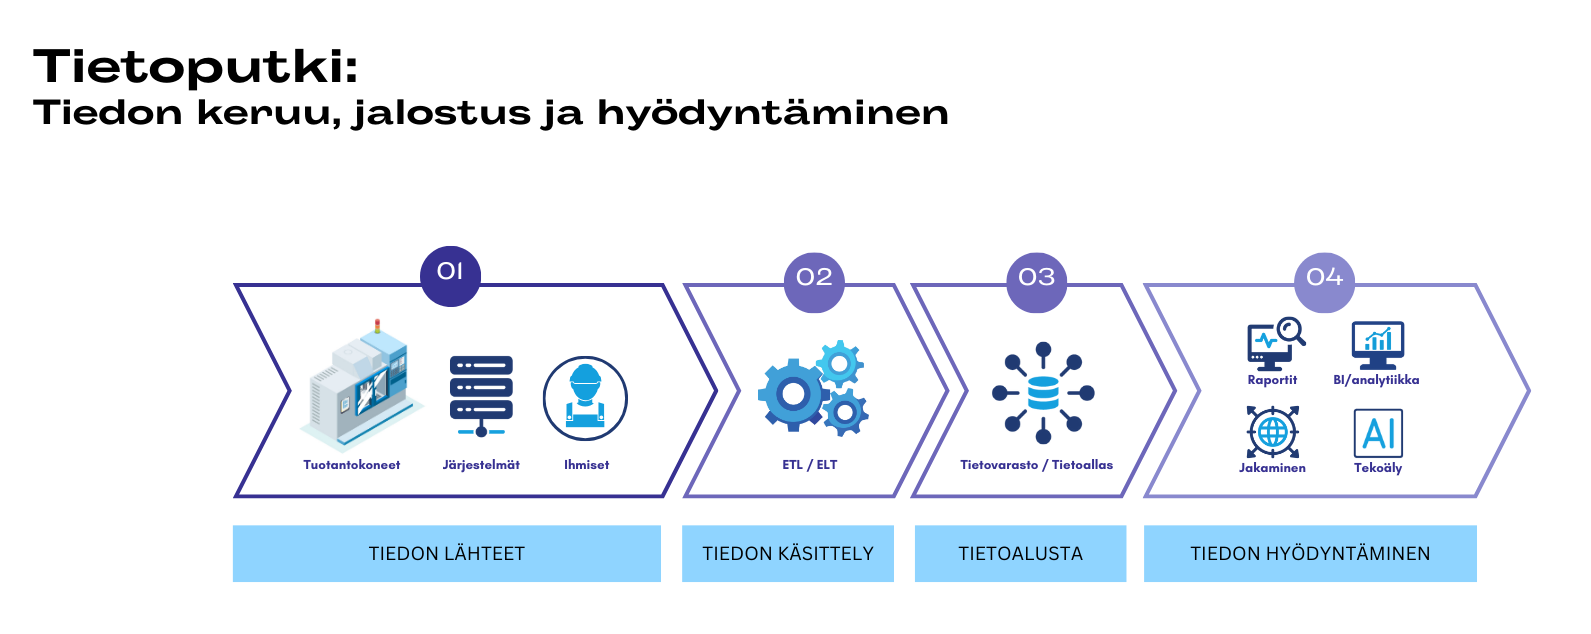
Tietoputken osien selitykset:
- Tiedon lähteet: Tuotantoympäristössä pääasiallisina tiedon lähteinä toimivat tuotantokoneet, ihmiset ja järjestelmät.
- Tiedon käsittely: Tietoa pitää yleensä käsitellä ja yhdistellä monin tavoin ennen kuin se on hyödynnettävässä muodossa. Kaksi pääasiallista lähestymistapaa ovat ETL (Extract, Transform, Load) ja ELT (Extract, Load, Transform), joiden ero on lähinnä siinä, missä vaiheessa tiedon muuttaminen tapahtuu.
- TietoalustaTietoalusta (Data Platform). Teknologinen kokonaisuus, joka tarjoaa työkalut datan keruuseen, tallennukseen, prosessointiin ja analysointiin.: Käsitellyn tiedon tallennuspaikka. Tyypillisesti itsenäinen tietovarasto tai tietoaltaan päälle rakennettu tietovarastokerros.
- Tiedon hyödyntäminen: Tietoalustalle kertyneen tiedon hyödyntäminen esim. raportoinnissa ja analytiikassa.
Tämänkaltaisista tietoputkista puhuttaessa monia mietityttää, miksi tietoa kopioidaan paikasta toiseen. Miksei vain tehdä toteutusta, missä mittarit yhdistyvät suoraan operatiivisiin tietokantoihin ja muihin tietolähteisiin? Voisiko vaikka Power BI liittää suoraan mm. toiminnanohjausjärjestelmän tietokantaan, poimia vain tarvittavat kentät tauluista ja tehdä tarvittavat datan muutokset ja yhdistelyt Power BI päällä? Silloinhan tieto olisi aina ajantasaista ja voitaisiin vähentää tiedon käsittelyn vaiheita lähteestä hyödyntämiseen.
Periaatteessa yllä kuvattu toimintatapa on mahdollinen tarkkaan rajatuissa käyttötapauksissa, jossa lähtödata ja tarvittavat käsittelyvaiheet ovat etukäteen hyvin ymmärrettyjä. Laajempaa mittaristoa ja monimutkaisempia tiedon käsittelytarpeita ajatellen tällaisen toteutustavan rajat tulevan pian vastaan.
Tiedon kokoamisella tietovarastoon voidaan saavuttaa mm. seuraavia hyötyjä:
- Suoraan operatiivisiin tietokantoihin liitettävät analytiikkaratkaisut voivat aiheuttaa järjestelmien hidastumista. Tavalliset tietokannat eivät muutenkaan ole optimoituja analytiikan tarpeisiin.
- Operatiiviset tietokannat eivät yleensä tallenna historiatietoja kovinkaan tarkasti. Historiatietojen säilyttäminen ja hyödyntäminen on mahdollista tietovarastoissa.
- Tietoalustat mahdollistavat suurienkin datamassojen käsittelyn ja hyödyntämisen analytiikassa.
- Eri lähteistä tulevien tietojen liittäminen onnistuu parhaiten, kun tiedot on käsitelty yhtenäiseen muotoon samalla alustalla.
Yrityksenne kannattaa käsitellä seuraavia asioita ennen tietovarastoprojektiin ryhtymistä:
- Mitä liiketoiminnan ongelmia ja tietotarpeita tietovarastolla halutaan ratkaista?
- Saadaanko tietotarpeet ratkaistua ilman erillisen tietovaraston luomista vaikka tietojärjestelmien omien raportointiominaisuuksien avulla?
- Mitkä ovat yrityksen keskeiset suorituskykymittarit (KPI) ja muut analytiikkatarpeet?
Erillisten tietovarastojen toteuttaminen ei ole järkevää ja välttämätöntä kaikille yrityksille kaikissa tilanteissa. Varsinkin pienempien ja tietojohtamisessa alkutaipaleella olevien yritysten kannattaa käyttää rajalliset resurssinsa viisaasti. Näissäkin tapauksissa tiedolla johtamisen osaamisen kehittäminen on kannattavaa pidemmällä aikavälillä.
Alla on joitain vinkkejä, jos tietovarasto vaikuttaa tilanteeseenne nähden ylimitoitetulta:
- Käytössä olevien tietojärjestelmien ja erityisesti niiden raportointimahdollisuuksien laajempi hyödyntäminen.
- Excel on edelleen pätevät työkalu tietojen yhdistelyyn ja analyysiin. Myös esim. Power BI on hyödyllinen ilman tietovarastoakin.
- Kannattaa hankkia ulkopuolista tietojenkäsittelyn ja tiedolla johtamisen osaamista, jos yrityksestä ei sitä jo löydy. Konsultti, harjoittelija tai vaikka määräaikainen data-analyytikkoData-analyytikko (Data Analyst). Analysoi dataa ja tuottaa raportteja. voi auttaa monella tapaa yrityksen sen hetkisen tilanteen selvittämisessä ja kehittämiskohteiden löytämisessä.
- Näkyvän tiedon lisäksi kannattaa pyrkiä hyödyntämään ja jakamaan yrityksen hiljaista tietoa, koska se on usein jopa näkyvää tietoa arvokkaampaa.
- Yrityskulttuuria voi kehittää pitkäjänteisesti yhä paremmin tiedolla ohjautuvaksi.
Tietovarastojen historia
Tietovarastot (Data Warehouse) syntyivät vastauksena organisaatioiden tarpeeseen yhdistää eri tietojärjestelmissä sijaitsevaa dataa raportointia, analytiikkaa ja päätöksentekoa varten. Ennen tietovarastojen yleistymistä raportit tuotettiin pääosin suoraan operatiivisista järjestelmistä, jotka oli suunniteltu päivittäisten liiketoimintatapahtumien käsittelyyn eikä laajamittaiseen analysointiin. Tämä vaikeutti kokonaiskuvan muodostamista organisaation toiminnasta.
Tietovarastoinnin teoria alkoi muotoutua 1980-luvun lopulla ja 1990-luvun alussa. Alan keskeiseksi vaikuttajaksi nousi Bill Inmon, joka määritteli tietovaraston aihealueittain järjestetyksi, integroiduksi, historiatietoa sisältäväksi tietokokonaisuudeksi, jonka tarkoituksena on tukea johtamista ja päätöksentekoa. Inmonin mukaan organisaatioon tulisi rakentaa keskitetty yritystason tietovarasto, josta analytiikka- ja raportointiratkaisut johdetaan.
1990-luvulla Ralph Kimball esitti vaihtoehtoisen lähestymistavan, jossa tietovarasto rakennetaan liiketoimintalähtöisesti vaiheittain. Kimballin tunnetuin kontribuutio oli tähtimallin (Star Schema) popularisointi, mikä mahdollisti tehokkaan raportoinnin ja analysoinnin. Inmonin ja Kimballin näkemykset muodostivat kaksi tietovarastoinnin klassista koulukuntaa: keskitetyn yritystason tietovaraston ja liiketoimintayksiköiden tarpeista vaiheittain rakentuvan tietovaraston.
2000-luvulla tietovarastoista tuli keskeinen osa Business IntelligenceBusiness Intelligence (BI). Menetelmät ja työkalut datan raportointiin ja visualisointiin. -ratkaisuja. Organisaatiot rakensivat tietovarastoja yhdistääkseen tietoa toiminnanohjausjärjestelmistä, asiakkuudenhallinnasta, taloushallinnosta ja muista keskeisistä tietolähteistä. Tietovarasto vakiintui tiedolla johtamisen perustaksi, jonka päälle rakennettiin raportointi-, mittarointi- ja analytiikkaratkaisuja.
2010-luvulla pilvipalveluiden yleistyminen muutti tietovarastojen toteutustapoja merkittävästi. Samalla tietoaltaat (Data Lake) nousivat vaihtoehtoiseksi tavaksi tallentaa suuria määriä raakadataa ilman perinteisen tietovaraston tiukkaa mallinnusta. Tämä synnytti uusia arkkitehtuurimalleja, joissa tietovarastot ja tietoaltaat täydentävät toisiaan.
Viime vuosina kehitys on johtanut hybridimalleihin, kuten Data Lakehouse -arkkitehtuuriin, jossa yhdistetään tietoaltaiden joustavuus ja tietovarastojen analytiikkaominaisuudet. Myös reaaliaikainen datankäsittely, pilvinatiivit data-alustat, data meshData meshHajautettu arkkitehtuuri, jossa data omistetaan ja hallitaan liiketoiminta-alueittain. -ajattelu sekä tekoälyn hyödyntäminen ovat laajentaneet perinteisen tietovaraston roolia. Nykyisin tietovarastot ovat osa laajempia data-alustoja, jotka tukevat analytiikan lisäksi mm. tekoälysovelluksia ja tiedon jakamista.
Vaikka teknologiat ovat kehittyneet huomattavasti, tietovarastojen perimmäinen tarkoitus on säilynyt samana jo vuosikymmeniä: tarjota organisaatiolle luotettava, yhtenäinen ja historiallinen näkymä sen toiminnasta päätöksenteon tueksi.
Mikä tietovarasto on?
Tähän asti tietovarastosta on puhuttu melko laveassa merkityksessä. Peruskäsitteistön ymmärtäminen on keskeistä, ettei puhuta ristiin eri asioista. Jos tietovaraston käsite ja sen yhteydet lähikäsitteisiin eivät ole hallussa, voidaan sortua valitsemaan tarpeisiin nähden epäsopivat ratkaisut.
Tietovarasto (Data Warehouse) on yksi ”tietoalustan” (Data Platform) muoto. Lähikäsitteitä ovat mm. tietokanta (Database), tietoallas (Data Lake), datamarttiDatamartti (Data Mart). Tietovaraston rajattu osa, joka palvelee tietyn liiketoiminta-alueen raportointi- ja analytiikkatarpeita. (Data Mart), tietoallasvarastoTietoallasvarasto (Data Lakehouse). Arkkitehtuuri, joka yhdistää tietoaltaan joustavuuden ja tietovaraston rakenteisen analytiikan. Mahdollistaa sekä raakadataan perustuvan analyysin että perinteisen raportoinnin samassa ympäristössä. (Data Lakehouse), data meshData meshHajautettu arkkitehtuuri, jossa data omistetaan ja hallitaan liiketoiminta-alueittain., tietovaranto (Data Repository)... Käsitteet menevät päällekkäin ja konsultit kehittävät jatkuvasti uusia käsitteitä myydäkseen palveluitaan. Useimmille riittää hahmottaa kolmen keskeisen käsitteen merkitys ja eroavaisuudet: tietovarasto, tietokanta ja tietoallas.
Tietokanta on järjestelmä, joka on tarkoitettu tietojen käsittelyyn ja ylläpitoon. Perinteiset tietokannat perustuvat ns. relaatiomalliin, jossa tieto koostuu rivejä ja sarakkeita sisältävistä tauluista. On myös toisenlaisia tietokantamalleja, jotka voivat perustua dokumentteihin, avain-arvo-pareihin tai vaikka vektoreihin (näitä kutsutaan NoSQL-tietokannoiksi). Tietokanta käyttää tietokantajärjestelmää (DBMS), joka huolehtii datan eheydestä ja kyselyistä. Esimerkiksi Excel ei ole tietokanta, koska se ei käytä tietokantajärjestelmää. Tietokanta voi olla pilvipohjainen tai vaikka omalla tietokoneella pyörivä. Järjestelmien taustalla oleva operatiivinen tietokanta perustuu OLTPOLTP (Online Transaction Processing). Tietojärjestelmä tai tietokanta, joka on optimoitu päivittäisten liiketoimintatapahtumien (transaktioiden) nopeaan käsittelyyn.-malliin, joka painottaa nopeita kirjoituksia ja päivityksiä. Tiedot on pyritty normalisoimaan mahdollisimman pitkälle esim. 3NF-mallia käyttäen.
Tietovarasto on käytännössä yleensä tietokanta, joka on optimoitu analytiikkaa ja raportointia varten. Siinä missä ohjelmien taustalla pyörivät tietokannat ovat optimoitu mahdollistamaan nopeat kirjoitukset, OLAPOLAP (Online Analytical Processing). Teknologia ja toimintatapa, joka mahdollistaa monimutkaisen analyysin suurista datamassoista. Optimoitu erityisesti raportointiin ja aggregointeihin, ei operatiivisiin transaktioihin.-malliin pohjautuvat tietovarastot ovat puolestaan optimoituja tietojen hakuun ja koonteihin (aggregointi). Tietovarastossa tiedot ovat tyypillisesti lähtöisin monista eri lähteistä ja ne on muokattu sekä yhdistetty analyysin kannalta valmiimpaan muotoon. Tietovarastoissa historiatiedon säilyttäminen on usein tärkeämmässä roolissa kuin operatiivisissa järjestelmissä. Tietovarastossa tieto voi olla useassa eri jalostusasteessa, joista hyödyntäjille näkyvissä tasoissa on käytetty tietomallina esim. tähtimallia (Star Schema). Tietovaraston pääasiallinen tehtävä on tukea päätöksentekoa ja toimia tiedolla johtamisen pohjana.
Tietoallas on on keskitetty tallennuspaikka, jossa voidaan säilyttää suuria määriä raakadataa – rakenteista, puolistrukturoitua ja strukturoimatonta – alkuperäisessä muodossaan myöhempää analyysiä varten. Tietoaltaat alkoivat yleistymään 2000-luvun ensimmäisellä vuosikymmenellä Big Data -buumin myötä. Datan jalostaminen tapahtuu yleensä tietoaltaan päällä (ns. ELT-prosessiELT-prosessi (Extract–Load–Transform). Dataintegraatiomenetelmä, jossa data poimitaan eri lähteistä, ladataan sellaisenaan kohdejärjestelmään ja muokataan vasta siellä analytiikkaa varten.), kun tietovarastojen yhteydessä tietoa muokataan yleensä jo ennen tietovarastoon tuomista (ns. ETL-prosessiETL-prosessi (Extract–Transform–Load). Prosessi, jossa data kerätään lähteistä, muokataan analysoitavaan muotoon ja tallennetaan tietovarastoon.). Viime vuosina ovat yleistyneet tietoallasvaraston (Data Lakehouse) kaltaiset hybridimallit, joissa tietoaltaassa olevaa raakadataa jalostetaan kerroksittain perinteisemmän tietovarastoratkaisun kaltaiseen muotoon.
Tiivistäen tietovarasto ON seuraavia asioita:
- Useista lähteistä tietoa kokoava järjestelmä raportointia, analytiikkaa ja päätöksentekoa varten.
- Hyvin määritelty, jäsennelty ja käyttötarkoituksen mukaan mallinnettu tietokokonaisuus.
- Yhteisesti hyväksytty raportointitiedon lähde ("yhden totuuden lähde"), jossa mittarit ja laskentasäännöt toteutetaan yhdenmukaisesti.
- Historiatietoa säilyttävä järjestelmä, jonka avulla voidaan tarkastella toiminnan muutoksia ja kehitystä ajassa.
- Operatiivisista järjestelmistä erillinen analytiikkaympäristö, joka vähentää raportoinnin aiheuttamaa kuormitusta lähdejärjestelmille.
- Tietojen alkuperän, muunnosten ja laskennan jäljitettävyyttä tukeva ratkaisu.
- Tiedon laatua näkyväksi tekevä kokonaisuus, jossa puuttuvat, ristiriitaiset ja virheelliset tiedot voidaan tunnistaa.
- Vaiheittain kehitettävä ratkaisu, jota laajennetaan uusilla tietolähteillä ja käyttötapauksilla liiketoiminnan tarpeiden perusteella.
- Tekninen ja toiminnallinen kokonaisuus, joka tarvitsee määritellyt omistajat, ylläpitovastuut, käyttöoikeudet, dokumentaation ja laadunvalvonnan.
Tietovarasto EI OLE:
- Sama asia kuin tietoallas. Tarkoittaa sitä, ettei tietovarastoon suoraan tallenneta kaikkea mahdollista raaka-dataa Excel-tiedostoista vaikkapa kuviin ja äänitiedostoihin saakka. Tietoaltaan päälle voidaan rakentaa tietovaraston kaltaisia kerroksia, kuten ns. ”Data Lakehouse” järjestelmissä, joissa tietovaraston voi sanoa olevan osa tietoalustaa.
- Ohjelmiston operatiivinen tietokanta. Tietovarastoa ei siis käytetä tietojärjestelmien tavallisten transaktioiden käsittelyssä. Tämä ei tarkoita, etteikö samalla tietoalustalla tai peräti samassa tietokannassa voi olla sekä jonkin järjestelmän operatiivista tietokantaa että tietovarastoa.
- Excel-tiedosto tai Power BI:n semanttinen tietomalli. Tietovarasto vaatii yleensä määritelmän mukaan tietokantaohjelmiston taustalle ja sen on tuettava SQL-muotoisia kyselyitä.
- Tietojen jakoalusta sellaisenaan. Tietovaraston/tietoalustan päälle voidaan tarvittaessa rakentaa rajapintoja tietojen jakamiseen esim. arvoketjun muille toimijoille tai vaikkapa tekoälymaleille.
- Semanttinen malli (Semantic Model). Liiketoimintatermistön ja mittarit tekniseen toteutukseen yhdistävä semanttinen malli rakennetaan yleensä tietovaraston päälle, mutta ei ole suoraan osa tietovarastoa.
- Yrityksen ydintiedon (Master Data) hallintajärjestelmä. Nämä ovat yleensä erillisiä järjestelmiä, mutta ne voivat liittyä tietovarastoon lähteinä tai hyödyntäjinä.
- Itsessään analytiikkaratkaisu, vaan pelkästään tiedon tallennuspaikka. Monissa tietoalustoissa on integroituna analytiikkatyökaluja.
Mitä vaiheita ja valintoja tietovaraston toteutukseen liittyy?
Tietovarastossa keskeistä on, että sen suunnittelun ja toteutuksen pitää lähteä liiketoimintatarpeista. Ennen tietovarastoprojektin toteuttamista yrityksen tulee olla käynyt edes jossain määrin läpi monia edeltäviä tietojohtamisen vaiheita.
- Yrityksen datastrategian luominen.
- Eri henkilöstöryhmien tietotarpeiden selvittäminen.
- Olemassa olevien liiketoimintaprosessien, lähdejärjestelmien ja niiden tuottaman datan ymmärtäminen rajoitteineen.
- Käsitemallinnus ja sen pohjalta tietomallinnus.
- Tietovaraston käyttötapausten määritys.
- Seurattavien mittareiden määritys.
- Tiedolla johtamisen prosessit: oikea tieto oikeille henkilöille oikeaan aikaan.
Alla on tyypilliset tietovaraston toteutuksen vaiheet yleisellä tasolla. Vaiheet menevät limittäin ja voivat edetä iteratiivisesti.
- Esivalmistelu (katso ylempää)
- Käsitemallin pohjalta loogisen tietomallin määrittely ja metatiedon kuvaaminen
- Tietoalustan arkkitehtuurimallin valinta
- PoC-toteutus valitulle arkkitehtuurille
- Tietovarastoprojektin roolien määrittäminen
- ETL/ELT prosessien toteutus eri tietolähteille
- Datan yhdistely ja jatkojalostaminen tietovaraston päällä
- Semanttisen kerroksen luominen analytiikkakäyttöä varten
- Tietoputkien testaus ja datan validointi
- BI-työkalujen liittäminen ja raporttien luominen
- Käyttöönotto ja siihen liittyen käyttäjien koulutus tietovaraston ja raporttien hyödyntämiseen
- Tietovaraston ylläpito ja kehittäminen
Tietovarastoprojekti on IT-järjestelmäprojekti siinä missä muutkin. Ehkä merkittävimpänä eroavaisuutena on, ettei tietovarastoja voi ostaa sellaisenaan kaupan hyllyltä vaan jokainen tietovarasto rakennetaan yrityksen tarpeisiin ja olemassa oleviin järjestelmiin sovitettuna. Siinä mielessä tietovarastoprojekti on enemmänkin yritykselle alusta asti rakennetun IT-järjestelmän kaltainen ja siihen kannattaa suhtautua samankaltaisena projektina. Kuten uuden IT-järjestelmän toteutuksessakin, kannattaa tässä edetä askeleittain PoC-toteutuksista (Proof-of-Concept), MVP (Minimum Viable Product) kautta laajempaan järjestelmään.
Loppupeleissä jonkin tietoalustan päälle rakennetun raportin hyödyntäjän kannalta ei ole suurtakaan merkitystä, ovatko raportin tiedot lähtöisin jaetuista Excel-tiedostoista, yrityksen sisäverkkoon pystytetystä kevyestä tietovaraston virkaa hoitavasta PostgreSQL-tietokannasta vai modernien työkalujen päälle rakennetusta pilvipohjaisesta Microsoft Fabric Data Lakehousesta. Loppukäyttäjää kiinnostaa, ovatko hänen seuraamissaan mittareissa luotettavat ja ajantasaiset tiedot.
Liiketoimintanäkökulma sekä yrityksen todelliset tarpeet täytyy aina pitää mielessä, sillä on hyvin helppo eksyä tietoalustan teknisten yksityiskohtien kanssa painimiseen (eli tiedon johtamiseen) tiedolla johtamisen tarpeet unohtaen. Tästä huolimatta tekniseen toteutukseen liittyvät valinnat ovat myös tärkeitä, kun tietovarastoa lähdetään pystyttämään, sillä erilaisissa ratkaisuissa on kaikissa omat haasteensa ja mahdollisuutensa.
Kunhan alkaa olla tiedossa, mihin tietovarastoa halutaan käyttää, mitä vaatimuksia tietovarastolle on ja millainen on käytettävä tietomalli, voidaan tietovarasto toteuttaa käytännössä. Oletuksena tietovaraston tekniseen suunnitteluun lähdettäessä on, että mm. yrityksen tietotarpeet ja mittarit on määritetty, datalähteet on tunnistettu, datastrategiaDatastrategia (Data Strategy). Suunnitelma siitä, miten dataa hyödynnetään liiketoiminnan tavoitteiden saavuttamiseksi. on päivitetty ja johto on sitoutunut tietovaraston toteutusprojektiin.
Tietovaraston toteutustapaan liittyviä kysymyksiä pohdittavaksi:
- Paljonko dataa on? Ovatko käsiteltävät datamassat suuria (teratavuluokkaa) vai suhteellisen pieniä?
- Toteutetaanko tietovarasto pilvipohjaisena vai yrityksen omaan palvelinympäristöön (ns. ”on-premises”)?
- Mitkä ovat pilvipalvelun kuukausikustannukset, jos toteutetaan pilvipohjaisena?
- Onko jotain tietoa tarvetta jakaa muille yrityksille rajapintojen kautta arvoketjussa? Voisiko tiedon jakaminen olla osa samaa tietoalustaa?
- Mikä on yrityksen budjetti ja henkilöstöresurssit tietovaraston toteutukseen, ylläpitoon ja jatkokehittämiseen?
- Halutaanko sitoutua johonkin tiettyyn tarjoajaan? Tällaisia kokonaisalustoja tarjoavia yrityksiä ovat mm. Microsoft Fabric, Snowflake, Google Cloud jne.
- Mitkä ovat tietovaraston käyttötapaukset ja mitkä henkilöryhmät tietovaraston tietoja hyödyntävät?
- Halutaanko toteutuksesta tehdä esim. kielimallien kanssa yhteensopiva, jos jatkossa halutaan tehdä agenttipohjaisia ratkaisuja tai käyttää kielimalleja analytiikan tukena?
- Missä lähdejärjestelmien data sijaitsee ja miten siihen päästään käsiksi?
- Ketkä omassa organisaatiossa ovat pääkäyttäjiä? Miten oma osaaminen varmistetaan? Miten tietovarasto jalkautetaan henkilöstölle käyttöön?
- Onko tarvetta palkata yritykseen lisäosaamista, jos sisäinen osaaminen ei riitä?
- Millainen kerrosarkkitehtuuri tiedolle tehdään? Käytetäänkö vaikka mitaliarkkitehtuuria?
- Tehdäänkö tietoputket ETL vai ELT periaatteen mukaisesti?
- Miten historiatieto otetaan huomioon ja hyödynnetään?
- Miten usein eri tietojen tarvitsee tietovarastossa päivittyä? Onko syytä tehdä (lähes) reaaliaikaisia ratkaisuja vai riittäisikö vaikka päivittäiset tietojen päivitykset?
- Tehdäänkö päivitykset inkrementaalisina vai täysinä päivityksinä?
- Miten huolehditaan tietoturvasta ja käyttöoikeuksista? Entä GDPR ja muut säädökset?
- Käytetäänkö tietomalleissa esim. Data VaultData VaultTietovarastojen mallinnusmenetelmä, jossa data organisoidaan kolmeen pääkomponenttiin (hub, link, satellite), jotta voidaan integroida data useista lähteistä, säilyttää täydellinen historia ja mahdollistaa joustava kehitys. mallia tai tähtimallia?
- Toteutetaanko semanttinen kerrosSemanttinen kerros (Semantic Layer). Abstraktiokerros tietovaraston ja käyttäjien välillä, jossa määritellään liiketoimintakäsitteet kuten "myynti" tai "kannattavuus". Varmistaa, että kaikki analysoivat dataa samalla tavalla. (Semantic Layer) tietovaraston päälle omana kerroksenaan?
- Kuka tai ketkä ovat kunkin datan omistajia?
- Miten metadataa hallitaan? Luodaanko datakatalogiDatakatalogi (Data Catalog). Työkalu tai palvelu, joka kokoaa metatiedon yhteen paikkaan ja auttaa löytämään, ymmärtämään ja hyödyntämään organisaation dataa. Sisältää usein datan kuvaukset, omistajat ja käyttöoikeudet.?
- Mitä työkaluja käytetään raporttien luomiseen ja muuhun analytiikkaan? Onko tietoalustaratkaisu miten yhteensopiva?
Alla suositeltua etenemisjärjestystä tietovarastoinnin suhteen erityisesti PK-yrityksille:
- Tunnista liiketoimintaongelma.
- Arvioi, tarvitaanko erillistä tietovarastoa.
- Valitse yksi rajattu käyttötapaus.
- Nimeä käyttäjät ja omistajat.
- Kartoita lähdejärjestelmät ja rajapinnat.
- Arvioi datan laatuDatan laatu (Data Quality). Datan soveltuvuus käyttötarkoitukseensa. Sisältää useita ulottuvuuksia, kuten tarkkuus, täydellisyys, ajantasaisuus ja yhtenäisyys. ja yhdistettävyys.
- Määrittele käsitteet ja mittarit.
- Päätä historian käsittely ja tietojen tarkkuustaso.
- Suunnittele yksinkertainen tietomalli ja arkkitehtuuri.
- Valitse työkalut tarpeiden, kustannusten ja osaamisen perusteella.
- Toteuta rajattu kokeilu aidolla tai riittävän edustavalla datalla.
- Tarkista tietojen laatu ja täsmäytä tulokset lähdejärjestelmään.
- Toteuta automaatio, testit, lokitus ja virheilmoitukset.
- Dokumentoi ratkaisu ja kouluta vastuuhenkilöt.
- Ota ensimmäinen käyttötapaus hallitusti tuotantokäyttöön.
- Laajenna uusiin tietolähteisiin ja käyttötapauksiin vasta toimivan perustan päälle.
Muutama yleinen vinkki
- Tietovarastoprojektin ensimmäisessä vaiheessa on hyvä olla rajattu riittävän suppea ja selkeä käyttötapaus, että sen pohjalta voidaan tehdä PoC (Proof-of-Concept) tai MVP (Minimum Viable Product) toteutus.
- Valitkaa tietoalustat todellisten tarpeiden mukaan. Modernit pilvipohjaiset ratkaisut voivat olla useimpien PK-yritysten alkutarpeisiin nähden yliampuvia ja voivat aiheuttaa väärin käytettyinä suuria jatkuvia kustannuksia.
- Tavalliset relaatiopohjaiset tietokannat (esim. PostgreSQL, MySQL, MS SQL Server) ovat usein aivan riittäviä ensimmäisiksi PoC/MVP tietovarastoiksi. Näitä tavallisia relaatiopohjaisia tietokantoja voi käyttää myös pilvipohjaisina melko kustannustehokkaasti, jos oman tietokannan ylläpitoon ei riitä yrityksessä resursseja. Relaatiopohjaiset tietokannat toimivat tietovarastona satojen gigatavujen datamääriin asti, mutta viimeistään teratavuluokkaan siirryttäessä kannattaa siirtyä järeämpiin tietovarastoratkaisuihin.
- Jos yrityksen sisältä ei löydy osaamista data-analytiikasta, tietovarastoista ja tietomallinnuksesta, kannattaa harkita tällaisen henkilön palkkaamista yrityksen palkkalistoille tai ulkopuolisen konsultin käyttämistä.
Ensimmäisessä tietovarastototeutuksessa eteneminen
1. Tarpeen arviointi
- Määritä liiketoiminnan ongelma, jota tietovarastolla ratkaistaan. Tietovaraston rakentaminen ei ole itsessään tavoite.
- Selvitä, voidaanko tarve ratkaista nykyisen toiminnanohjausjärjestelmän, raportointityökalun tai yksinkertaisen tietokantaratkaisun avulla.
- Harkitse tietovarastoa erityisesti silloin, kun tietoa täytyy yhdistää useista järjestelmistä, historiatietoa täytyy säilyttää tai mittareiden laskenta halutaan yhdenmukaistaa.
- Kuvaa, mitä päätöksiä tietovaraston tiedoilla tehdään ja ketkä tietoja käyttävät.
- Määritä hankkeelle mitattavat tavoitteet, kuten raportoinnin työmäärän vähentäminen, tiedon laadun parantaminen tai uuden analyysin mahdollistaminen.
2. Toteutuksen rajaus
- Aloita yhdestä rajatusta käyttötapauksesta koko yrityksen kattavan tietovaraston sijaan.
- Valitse ensimmäiseksi käyttötapaus, jolla on tunnistettava liiketoimintahyöty, nimetty omistaja, tunnetut käyttäjät ja saatavilla oleva data.
- Konepajassa ensimmäinen käyttötapaus voi liittyä esimerkiksi tilauskohtaiseen kannattavuuteen, toimitusvarmuuteen, työvaiheiden toteuma-aikoihin, tuotannon kuormitukseen tai laatupoikkeamiin.
- Etene kokeilusta rajattuun tuotantokelpoiseen ratkaisuun ja laajenna vasta, kun ensimmäinen käyttötapaus toimii luotettavasti.
- Rajaa ensimmäiseen toteutukseen vain välttämättömät tietolähteet, tiedot, mittarit ja raportit.
3. Lähdejärjestelmien kartoitus
- Laadi luettelo käytettävistä lähdejärjestelmistä, kuten toiminnanohjaus-, tuotannonohjausTuotannonohjaus (Production control / Production planning and control). Toiminta, jolla suunnitellaan, ajoitetaan ja ohjataan tuotantoa-, taloushallinto-, laatu- ja kunnossapitojärjestelmistä sekä koneiden tietolähteistä.
- Dokumentoi jokaisesta lähteestä tietosisältö, omistaja, tekninen sijainti, rajapinnat, päivitystiheys ja historiatiedon saatavuus.
- Selvitä, voidaanko tieto hakea tietokannasta, ohjelmointirajapinnasta, tiedostosta vai muulla tavalla.
- Tarkista järjestelmien lisenssiehdot, rajapintarajoitukset ja mahdolliset tiedonsiirrosta aiheutuvat kustannukset.
- Tunnista tietojen yhdistämisessä tarvittavat avaimet, kuten tilausnumero, työnumero, nimikeNimike (Item / Product). Yksilöllinen tunniste tuotteelle, osalle tai materiaalille tuotannossa, työvaihe, kone, asiakas ja aikaleima.
- Varmista, että tarvittavat tunnisteet ovat saatavilla ja riittävän yhdenmukaisia eri järjestelmissä.
4. Datan laadun arviointi
- Arvioi datan laatuDatan laatu (Data Quality). Datan soveltuvuus käyttötarkoitukseensa. Sisältää useita ulottuvuuksia, kuten tarkkuus, täydellisyys, ajantasaisuus ja yhtenäisyys. ennen laajan teknisen toteutuksen aloittamista.
- Tarkista tietojen täydellisyys, yksikäsitteisyys, oikeellisuus, ajantasaisuus ja keskinäinen eheys.
- Selvitä, käytetäänkö samasta asiakkaasta, tuotteesta, koneesta tai työvaiheesta useita tunnisteita.
- Tarkista, ovatko tietotyypit, aikaleimat, mittayksiköt, valuutat ja koodistot yhdenmukaisia.
- Tunnista tiedot, joita käyttäjät kirjaavat puutteellisesti tai eri tavoin.
- Korjaa järjestelmälliset laatuongelmat ensisijaisesti siellä, missä tieto syntyy. Tietovarastossa tehtävä muunnos ei korvaa lähdejärjestelmän tiedonhallintaa.
- Dokumentoi laatuongelmat, joita ei voida heti korjata, ja kerro niiden vaikutus raportteihin ja mittareihin.
5. Käsitteet ja mittarit
- Määrittele keskeiset liiketoimintakäsitteet ennen tietomallin ja raporttien rakentamista.
- Dokumentoi jokaisesta mittarista nimi, tarkoitus, laskentakaava, tietolähteet, rajaukset, päivitystiheys, tarkastelutaso ja omistaja.
- Sovi esimerkiksi, mitä toimitusvarmuudella, läpimenoajalla, käyttöasteella, kapasiteetilla, tuotantokustannuksella ja kannattavuudella tarkoitetaan.
- Määritä, mikä järjestelmä tai tietolähde on ensisijainen, jos sama tieto esiintyy useassa paikassa.
- Varmista, että tietovarastossa ja raporteilla käytetyt käsitteet vastaavat liiketoiminnan käyttämää terminologiaa.
- Vältä saman mittarin laskemista eri tavoin eri raporteilla.
6. Tietomallin suunnittelu
- Suunnittele raportointiin tarkoitettu tietomalli liiketoiminnan kysymysten, ei lähdejärjestelmän teknisten taulujen perusteella.
- Hyödynnä tarvittaessa dimensionaalista mallinnusta, jossa tapahtumat erotetaan niitä kuvaavista taustatiedoista.
- Tapahtumat voivat liittyä esimerkiksi tilauksiin, tuotantoon, työvaiheisiin, laatupoikkeamiin, materiaalinkulutukseen ja kustannuksiin.
- Taustatiedot voivat kuvata esimerkiksi aikaa, asiakasta, tuotetta, tilausta, työvaihetta, konetta ja työpistettä.
- Määritä tietojen tarkkuustaso. Päätä esimerkiksi, tallennetaanko tuotantotieto tilauksen, työvaiheen, tapahtuman, tunnin vai päivän tasolla.
- Älä kopioi toiminnanohjausjärjestelmän koko tietokantarakennetta sellaisenaan raportointimalliin.
- Pidä ensimmäinen tietomalli rajattuna, ymmärrettävänä ja laajennettavana.
- Dokumentoi taulujen, kenttien, avainten ja suhteiden lisäksi myös tietojen liiketoiminnallinen merkitys.
7. Historiatiedon käsittely
- Päätä, mitä historiatietoa tietovarastossa säilytetään ja kuinka pitkään.
- Määritä, seurataanko asiakkaiden, tuotteiden, kustannusten, luokitusten ja organisaatiorakenteiden muutoksia.
- Päätä, käytetäänkö raportoinnissa tapahtumahetken vai nykyhetken tietoja.
- Määritä, miten lähdejärjestelmässä korjatut, peruutetut ja poistetut tapahtumat käsitellään.
- Varmista, että laskenta voidaan tarvittaessa toistaa ja että muuttuneiden tulosten syy voidaan selvittää.
8. Arkkitehtuuri
- Pidä ensimmäinen tekninen kokonaisuus mahdollisimman yksinkertaisena.
- Tavallinen perusrakenne muodostuu lähdejärjestelmistä, tiedonsiirrosta, välitallennuksesta, tietojen muunnoksista, raportointimallista ja raportointityökalusta.
- Lisää uusia teknisiä kerroksia vain tunnistettuun tarpeeseen.
- Älä ota käyttöön tietoallasta, suoratoistoalustaa, erillistä tapahtumavälitystä tai useita tietokantamoottoreita ilman perusteltua käyttötapausta.
- Erottele raakadataRaakadata (Raw data). Prosessoimaton alkuperäinen data ennen analysointia, käsitelty data ja raportointiin hyväksytty data vähintään loogisesti toisistaan.
- Huomioi ratkaisun laajennettavuus, mutta älä rakenna ensimmäistä versiota epävarmojen tulevien tarpeiden varaan.
9. Tietojen päivitystiheys
- Aloita eräajopohjaisesta päivityksestä, ellei reaaliaikaisuudelle ole selkeää liiketoimintatarvetta.
- Päivitys voidaan tehdä esimerkiksi kerran vuorokaudessa tai useita kertoja työpäivän aikana käyttötapauksen mukaan.
- Määritä päivitystiheys erikseen jokaiselle tietolähteelle ja käyttötapaukselle.
- Arvioi reaaliaikaisuuden tarvetta sen perusteella, muuttaako viive käyttäjän tekemää päätöstä tai toimintaa.
- Huomioi, että tiheämpi päivitys lisää yleensä integraatioiden, valvonnan, virheenkäsittelyn ja lähdejärjestelmien kuormituksen vaatimuksia.
10. ETL- ja ELT-ratkaisut
- Valitse tietojen käsittelytapa ympäristön, osaamisen, tietomäärien ja ylläpitotarpeiden perusteella.
- ETL-malli soveltuu tilanteeseen, jossa tiedot halutaan muuntaa ennen niiden lataamista varsinaiseen tietovarastoon.
- ELT-malli soveltuu tilanteeseen, jossa raakadataRaakadata (Raw data). Prosessoimaton alkuperäinen data ennen analysointia ladataan ensin kohdeympäristöön ja muunnokset tehdään siellä.
- Raakadatan säilyttäminen voi helpottaa virheiden selvittämistä ja muunnosten uudelleen suorittamista, mutta lisää tallennus- ja hallintatarvetta.
- Älä valitse ETL- tai ELT-mallia pelkän teknologiasuuntauksen perusteella. Molemmat voivat olla pk-yritykselle käyttökelpoisia.
- Suosi mahdollisuuksien mukaan muunnoksia, jotka voidaan versionhallita, testata ja dokumentoida.
11. Työkalujen valinta
- Määritä tarvittavat tekniset kyvykkyydet ennen tuotteiden vertailua.
- Arvioi erikseen tallennus, tiedonsiirto, muunnokset, ajastus, testaus, lokitus, valvonta, versionhallinta, dokumentaatio ja raportointi.
- Valitse työkaluja, joihin yrityksellä tai sen kumppanilla on riittävä osaaminen.
- Hyödynnä olemassa olevaa teknologiaympäristöä silloin, kun se täyttää tarpeet eikä aiheuta kohtuutonta kustannusta tai riippuvuutta.
- Jos yritys käyttää jo Microsoftin tietokanta-, käyttäjähallinta- ja raportointiratkaisuja, Microsoft-pohjainen kokonaisuus voi vähentää uusien teknologioiden määrää.
- Avoimen lähdekoodin ratkaisut voivat pienentää lisenssikustannuksia, mutta ne eivät poista käyttöönoton, ylläpidon, valvonnan ja osaamisen kustannuksia.
- Pilvipalvelu voi vähentää oman infrastruktuurin ylläpitoa, mutta kustannusten muodostuminen, tietoturva, datan sijainti ja toimittajariippuvuus on arvioitava.
- Paikallinen ratkaisu voi olla perusteltu, jos tietolähteet ovat paikallisia, verkkoyhteydet ovat rajoittavia tai yrityksellä on tarvittava infrastruktuuri ja ylläpito-osaaminen.
- Älä hanki erillistä työkalua jokaiseen tekniseen tehtävään. Pieni työkalumäärä helpottaa ylläpitoa ja osaamisen hallintaa.
- Varmista, että työkalut tukevat yrityksen käyttämiä tietolähteitä ja kohdejärjestelmiä.
- Testaa kriittiset rajapinnat, tietojen päivitys ja suorituskyky käytännössä ennen pitkäaikaista sitoutumista.
12. Kevyt aloituskokonaisuus
- Pienessä ensimmäisessä toteutuksessa voi riittää yksi relaatiotietokantaRelaatiotietokanta (Relational Database). Taulupohjainen tietokanta, jossa data järjestetään riveihin ja sarakkeisiin ja taulujen välille määritellään suhteita., yksi tiedonsiirtomenetelmä, SQL- tai Python-pohjaiset muunnokset, ajastus, lokitus, versionhallinta ja raportointityökalu.
- Käyttöjärjestelmän ajastus voi riittää rajattuun kokeiluun, jos mukana on lokitus, virheilmoitukset ja selkeä ylläpitovastuu.
- Laajempi orkestrointityökalu kannattaa ottaa käyttöön, kun työnkulkujen määrä, riippuvuudet ja valvontatarpeet kasvavat.
- Erillinen metatietoMetatieto (Metadata). Kuvailevaa tietoa datasta, kuten rakenne, alkuperä, formaatti, merkitys ja käyttöoikeudet. Metatieto mahdollistaa datan löytämisen, ymmärtämisen ja hallinnan.- tai tietoluetteloalusta ei ole välttämätön ensimmäisessä toteutuksessa, jos käsitteet, tietolähteet, omistajat ja muunnokset dokumentoidaan muulla hallitulla tavalla.
- Työkalujen tekninen keveys ei saa tarkoittaa dokumentoinnin, testauksen tai tietoturvan sivuuttamista.
13. Kustannusten arviointi
- Arvioi kokonaiskustannus usean vuoden ajalta, ei vain alkuvaiheen lisenssihintaa.
- Ota huomioon lisenssit, tallennus, laskentakapasiteetti, tiedonsiirto, integraatiot, kehitys, testaus, valvonta, varmuuskopiointi, koulutus ja tekninen tuki.
- Arvioi myös oman henkilöstön työaika ja ulkopuolisen kumppanin kustannukset.
- Selvitä, miten kustannukset muuttuvat tietomäärien, käyttäjämäärien, päivitystiheyden ja laskentakuorman kasvaessa.
- Huomioi ratkaisun vaihtamisesta ja datan siirtämisestä mahdollisesti syntyvät kustannukset.
14. Tietoturva ja käyttöoikeudet
- Määritä käyttöoikeudet työtehtävien ja todellisen tietotarpeen perusteella.
- Erota tietovaraston tekniset ylläpito-oikeudet, kehittäjien oikeudet ja raporttien käyttäjien oikeudet toisistaan.
- Rajoita henkilötietojen, palkkatietojen, asiakashintojen ja muiden luottamuksellisten tietojen käyttöä.
- Käytä henkilökohtaisia käyttäjätunnuksia ja vältä tarpeettomia yhteiskäyttötunnuksia.
- Huolehdi tunnusten, salasanojen, avainten ja yhteysmerkkijonojen suojatusta säilyttämisestä.
- Dokumentoi, mitä tietoa järjestelmään tallennetaan, missä tieto sijaitsee ja kenellä on siihen pääsy.
- Sisällytä tietoturva ja tietosuoja suunnitteluun alusta lähtien.
15. Datan laadun testaus
- Toteuta automaattisia tarkistuksia keskeisille tiedoille.
- Tarkista esimerkiksi pakolliset arvot, yksikäsitteiset tunnisteet, viiteavaimet, sallitut arvot ja poikkeavat tapahtuma-ajat.
- Täsmäytä tietovaraston tulokset säännöllisesti lähdejärjestelmiin, erityisesti taloudellisesti tai toiminnallisesti tärkeissä tiedoissa.
- Määritä hyväksyttävät poikkeamat ja toimintatapa niiden ylityksille.
- Älä julkaise raporttia päätöksenteon tueksi ennen kuin sen keskeiset luvut on testattu ja hyväksytty.
16. Lokitus ja valvonta
- Tallenna jokaisesta päivitysajosta aloitus- ja päättymisaika, käsiteltyjen tietojen määrä, ajon tila ja mahdolliset virheet.
- Järjestä ilmoitus epäonnistuneista tai viivästyneistä päivityksistä.
- Varmista, että epäonnistunut ajo voidaan suorittaa uudelleen hallitusti.
- Estä mahdollisuuksien mukaan uusinta-ajojen aiheuttamat kaksoiskappaleet.
- Näytä raporttien käyttäjille, milloin tiedot on viimeksi päivitetty.
- Laadi toimintaohje yleisimmille virhetilanteille.
17. Versionhallinta ja ympäristöt
- Säilytä SQL-kyselyt, muunnoslogiikka, skriptit ja asetustiedostot versionhallinnassa.
- Dokumentoi muutosten tarkoitus, tekijä ja vaikutus.
- Erottele kehitys-, testi- ja tuotantoympäristöt ainakin silloin, kun tietovarastoa käytetään jatkuvassa johtamisessa tai taloudellisessa raportoinnissa.
- Testaa tietomallin, muunnosten ja mittareiden muutokset ennen tuotantoon vientiä.
- Määritä menettely, jolla muutokset hyväksytään ja tarvittaessa palautetaan.
18. Dokumentointi ja metadata
- Dokumentoi tietolähteet, tietomalli, tietovirrat, muunnossäännöt, mittarit, käyttöoikeudet ja ylläpitovastuut.
- Kuvaa, mistä raportin tieto tulee ja mitä käsittelyjä sille tehdään.
- Pidä tekninen dokumentaatio ja liiketoiminnan käsitemäärittelyt erillisinä mutta toisiinsa yhdistettyinä.
- Päivitä dokumentaatio osana muutoksen toteutusta, ei erillisenä jälkityönä.
- Käytä dokumentointitapaa, jota yritys pystyy ylläpitämään myös hankkeen tai ulkopuolisen toteuttajan työn päätyttyä.
19. Omistajuus ja ylläpito
- Nimeä tietovarastolle liiketoiminnallinen omistaja ja tekninen vastuuhenkilö.
- Nimeä keskeisille tiedoille ja mittareille omistajat, jotka hyväksyvät määritelmät ja ratkaisevat tulkintaerot.
- Määritä, kuka vastaa lähdedatan korjaamisesta ja kuka tietovarastossa tehtävistä muunnoksista.
- Varmista, ettei ratkaisu jää vain yhden työntekijän tai ulkopuolisen asiantuntijan tietämyksen varaan.
- Jos toteutus ulkoistetaan, säilytä yrityksessä ymmärrys tietolähteistä, käsitteistä, mittareista ja käyttötarkoituksista.
- Sovi kumppanin kanssa dokumentaation, lähdekoodin, käyttöoikeuksien, datan ja teknisten tunnusten omistuksesta.
- Kouluta yritykselle vähintään yksi henkilö, joka pystyy seuraamaan ajoja, tunnistamaan virheitä ja tilaamaan muutoksia hallitusti.
20. Tuotantokäytön vähimmäisvaatimukset
- Varmista automaattinen päivitys, lokitus, virheilmoitukset, laatutestit ja lähdejärjestelmään tehtävä täsmäytys.
- Varmista käyttöoikeuksien hallinta, palautettavuus, versionhallinta ja muutosten hyväksymismenettely.
- Dokumentoi mittarit, tietomalli, tietolähteet, päivitysaikataulu ja tunnetut rajoitteet.
- Nimeä tekninen ylläpitäjä, liiketoimintaomistaja ja virhetilanteiden käsittelijä.
- Ota tietovaraston tiedot johtamisen tai taloudellisen päätöksenteon käyttöön vasta, kun keskeisten lukujen luotettavuus on varmistettu.
On olemassa monenlaisia datan hallintaan ja hyödyntämiseen liittyviä rooleja eri osaamisineen ja vastuineen. Vaikkapa tietovarastoprojekteissa tarvitaan monenlaisia osaajia. Varsinkin pienemmissä yrityksissä roolit menevät limittäin, ja yksittäisenkin data-ammattilaisen odotetaan hallitsevan monia erilaisia kokonaisuuksia. Alla on muutamia tyypillisiä rooleja aakkosjärjestyksessä.
BI-asiantuntija (Business IntelligenceBusiness Intelligence (BI). Menetelmät ja työkalut datan raportointiin ja visualisointiin. Specialist) = Rakentaa raportointi- ja dashboard-ratkaisuja (esim. Power BI), jalostaa datasta visualisoitua tietoa ja tukee operatiivista ja taktista johtamista.
Data-analyytikkoData-analyytikko (Data Analyst). Analysoi dataa ja tuottaa raportteja. (Data Analyst) = Analysoi dataa, tuottaa raportteja ja tulkintoja päätöksenteon tueksi. Keskeinen rooli tiedolla johtamisessa muuttamalla data ymmärrettäväksi tiedoksi.
Data-arkkitehtiData-arkkitehti (Data Architect). Suunnittelee data-arkkitehtuurin. (Data Architect) = Suunnittelee organisaation koko data-arkkitehtuurin: miten data kerätään, integroidaan, mallinnetaan, hallitaan ja hyödynnetään liiketoiminnassa. Varmistaa, että data tukee strategiaa ja tiedolla johtamista.
DatainsinööriData-insinööri (Data Engineer). Vastaa datan keruusta ja tietoputkista. (Data Engineer) = Vastaa datan keruusta, integraatioista ja tietoputkista (ETL/ELT), varmistaen että laadukas data on analysoitavissa ja käytettävissä.
DataOps-insinööri (DataOps Engineer) = DatainsinööriData-insinööri (Data Engineer). Vastaa datan keruusta ja tietoputkista. ja ohjelmistokehittäjä, joka yhdistää ohjelmistokehityksen (DevOps) parhaat käytännöt datan hallintaan.
Datatieteilijä (Data Scientist) = Rakentaa tilastollisia ja koneoppimismalleja, ennustaa ilmiöitä ja tuottaa syvällisiä analyysejä liiketoiminnan kehittämiseen (erityisesti preskriptiivinen/prediktiivinen analytiikka).
Liiketoiminta-analyytikko (Business Analyst) = Tunnistaa liiketoiminnan tietotarpeet, määrittelee mittarit ja kytkee datan liiketoimintatavoitteisiin. Toimii sillanrakentajana datan ja päätöksenteon välillä.
TietoalustaTietoalusta (Data Platform). Teknologinen kokonaisuus, joka tarjoaa työkalut datan keruuseen, tallennukseen, prosessointiin ja analysointiin.-asiantuntija (Data Platform Engineer) = Vastaa tietoalustan toiminnasta, orkestroinnista ja automaatiosta.
Tietojohtaja (Chief Data Officer, CDO) = Vastaa datastrategiasta ja tiedolla johtamisen kokonaisuudesta.
Tietokanta-arkkitehti (Database Architect) = Suunnittelee yksittäisten tietokantojen rakenteen, teknologiat ja suorituskyvyn (esim. taulut, skeemat, indeksit), varmistaen datan tehokkaan tallennuksen, haun ja tietoturvan sovellus- ja järjestelmätasolla.
Miten tietovarastoprojektissa voi onnistua?
Näistä lähtökohdista tietovarastoprojektin onnistumisen todennäköisyys ei ole vahva:
- Tietovaraston toteutukselle ei ole selkeää liiketoimintalähtöistä tarvetta. Tietovarastoa tarvitaan parantamaan olemassa olevia tietojohtamisen prosesseja ja nostamaan yrityksen tietojohtamisen tasoa.
- Organisaatio ei ole dataohjautuva eli päätöksiä ei pyritä tekemään dataan perustuen.
- Mitattavat ja seurattavat asiat eivät ole etukäteen määritettyjä.
- Yritys ei ole laatinut yhteisiä määritelmiä keskeisille käsitteille eikä käsitemallia ole laadittu tietomallinnuksen pohjaksi.
- Organisaatiolta puuttuu sisäiset kyvykkyydet tietojohtamiseen ja tietojohtamisen johtaminen.
- Tiedon omistajuus ei ole määritetty.
- Organisaatiossa ei ole riittävästi omaa teknistä osaamista ja ymmärrystä mm. tietoalustoista, data-analytiikasta, raportoinnista, tietojärjestelmistä ja tietomallinnuksesta.
- Organisaatiokulttuuri ei tue tiedolla johtamista. Tietoa ei jaeta sisäisesti, virheitä piilotellaan eikä luottamus ole vahva.
- Tietovarastoprojekti ulkoistetaan ulkopuoliselle toimijalle ilman omaa aktiivista osallistumista.
- Liiketoimintaprosessit ja tietojohtamisen prosessit eivät ole riittävän tarkalla tasolla ymmärrettyjä ja
- Tietovarastoprojektiin suhtaudutaan teknisenä projektina eikä lähtökohtana ole lisäarvon tuominen liiketoimintaan.
- Tietovarastoprojektissa lähdetään haukkaamaan kerralla liikaa eikä rajata alustavaa toteutusta riittävän pieneksi (POC)
- Tietovarastoprojektia lähdetään toteuttamaan trendikkäitä uusia teknologioita käyttäen ottamatta huomioon todellisia tarpeita ja resursseja.
- Tavoitteet ovat epärealistisia resursseihin nähden.
Tietovarastoprojektin onnistumista edesauttaa:
-
Selkeä liiketoimintatavoite: Määritä, mitä ongelmaa tietovarasto ratkaisee, mitä päätöksiä se tukee ja millä mittareilla hankkeen onnistumista arvioidaan.
-
Rajattu ensimmäinen käyttötapaus: Aloita pienestä kokonaisuudesta, jolla on tunnistettava hyöty, nimetyt käyttäjät ja saatavilla oleva data. Laajenna vasta toimivan perustan päälle.
-
Johdon tuki ja omistajuus: Nimeä liiketoiminnallinen omistaja, tekninen vastuuhenkilö sekä tietojen ja mittareiden omistajat. Varmista päätöksenteon ja resurssien jatkuvuus.
-
Liiketoiminnan ja tekniikan yhteistyö: Ota käyttäjät mukaan vaatimusten, käsitteiden, mittareiden, tietomallin, raporttien ja hyväksymiskriteerien määrittelyyn.
-
Lähdejärjestelmien tunteminen: Kartoita tietolähteet, rajapinnat, avaimet, päivitystiheydet, historiatiedot, rajoitteet ja järjestelmien omistajat ennen toteutuksen aloittamista.
-
Riittävä datan laatuDatan laatu (Data Quality). Datan soveltuvuus käyttötarkoitukseensa. Sisältää useita ulottuvuuksia, kuten tarkkuus, täydellisyys, ajantasaisuus ja yhtenäisyys.: Arvioi tietojen oikeellisuus, täydellisyys, ajantasaisuus, yksikäsitteisyys ja yhdistettävyys. Korjaa järjestelmälliset virheet ensisijaisesti tiedon syntypaikassa.
-
Yhteiset käsitteet ja mittarit: Laadi sanasto ja dokumentoi mittarien tarkoitus, laskentakaavat, rajaukset, tietolähteet, tarkastelutasot ja omistajat.
-
Tarkoitukseen sopiva tietomalli: Suunnittele malli liiketoiminnan kysymysten perusteella. Määritä tietojen tarkkuustaso, avaimet, suhteet ja historiatietojen käsittely.
-
Yksinkertainen ja laajennettava arkkitehtuuri: Valitse ratkaisu nykyisten käyttötapausten mukaan. Vältä tarpeettomia teknisiä kerroksia, työkaluja ja ennakoituihin tulevaisuuden tarpeisiin perustuvaa monimutkaisuutta.
-
Osaamiseen sopivat työkalut: Valitse teknologiat yrityksen tarpeiden, osaamisen, ylläpitokyvyn, yhteensopivuuden, kokonaiskustannusten ja siirrettävyyden perusteella.
-
Hallittu vaiheistus: Etene kokeilusta rajattuun tuotantoversioon. Aseta jokaiselle vaiheelle tavoite, hyväksymiskriteerit ja käyttäjille näkyvä lopputulos.
-
Testattavat ja toistettavat tietoprosessit: Toteuta tiedonsiirrot ja muunnokset siten, että ne voidaan testata, suorittaa uudelleen ja palauttaa hallitusti ilman kaksoiskappaleita tai tietojen katoamista.
-
Täsmäytys ja laadunvarmistus: Vertaa tietovaraston keskeisiä lukuja lähdejärjestelmiin. Testaa avaimet, viitesuhteet, pakolliset tiedot, laskentasäännöt ja poikkeustilanteet.
-
Lokitus ja valvonta: Seuraa päivitysten tilaa, kestoa, tietomääriä ja virheitä. Ilmoita epäonnistuneista tai viivästyneistä ajoista nimetylle vastuuhenkilölle.
-
Tietoturva ja käyttöoikeudet: Rajaa pääsy työtehtävien perusteella. Suojaa tunnukset ja luottamukselliset tiedot sekä huomioi tietosuoja jo suunnitteluvaiheessa.
-
Version- ja muutoshallinta: Säilytä tietomallit, kyselyt, skriptit ja asetukset versionhallinnassa. Testaa ja hyväksy muutokset ennen tuotantoon siirtämistä.
-
Ajantasainen dokumentaatio: Dokumentoi tietolähteet, tietovirrat, muunnokset, tietomalli, mittarit, vastuut, käyttöoikeudet, rajoitteet ja arkkitehtuurivalintojen perusteet.
-
Käyttäjien koulutus ja käyttöönotto: Kouluta käyttäjät tulkitsemaan tietoja ja mittareita oikein. Kerää palautetta ja seuraa, otetaanko ratkaisu todelliseen käyttöön.
-
Yrityksen oman osaamisen säilyttäminen: Varmista, ettei ratkaisu jää yhden henkilön tai toimittajan varaan. Sovi datan, lähdekoodin, tunnusten ja dokumentaation omistuksesta.
-
Jatkuva seuranta ja kehittäminen: Arvioi käytön, laadun, kustannusten ja liiketoimintahyötyjen toteutumista. Kehitä tietovarastoa todellisten käyttötarpeiden perusteella.
Miten tieto mallinnetaan?
Tiedon mallintaminen tietovarastoja varten on vaiheittainen prosessi, jossa liiketoiminnan tietotarpeet muunnetaan tekniseksi toteutukseksi. Tiedon mallintaminen on keskeinen osa datan ymmärtämisen ja tietotarpeiden määrittelyn prosessia. Tiedon mallintamisen prosessi jaetaan tyypillisesti kolmeen vaiheeseen, joiden tuotoksina syntyy käsitemalliKäsitemalli (Conceptual Data Model). Alustava liiketoimintalähtöinen kuvaus datasta ilman teknisiä yksityiskohtia. (Conceptual Data Model), looginen tietomalliLooginen tietomalli (Logical Data Model). Käsitemallia tarkempi kuvaus, jossa määritellään entiteetit (taulut), attribuutit (sarakkeet), tietotyypit ja relaatiot. (Logical Data Model) ja fyysinen tietomalliFyysinen tietomalli (Physical Data Model). Konkreettinen toteutus tietokannassa. Määrittää tarkat taulujen ja sarakkeiden nimet, indeksit, avaimet, rajoitteet ja muistitilan. (Physical Data Model).
KäsitemalliKäsitemalli (Conceptual Data Model). Alustava liiketoimintalähtöinen kuvaus datasta ilman teknisiä yksityiskohtia. kuvaa mitä tietoja tarvitaan, looginen tietomalliLooginen tietomalli (Logical Data Model). Käsitemallia tarkempi kuvaus, jossa määritellään entiteetit (taulut), attribuutit (sarakkeet), tietotyypit ja relaatiot. kertoo miten tieto jäsennetään ja fyysinen tietomalliFyysinen tietomalli (Physical Data Model). Konkreettinen toteutus tietokannassa. Määrittää tarkat taulujen ja sarakkeiden nimet, indeksit, avaimet, rajoitteet ja muistitilan. miten tietomalli toteutetaan tietoalustalla. Näiden kolmen mallin lisäksi on syytä ottaa huomioon semanttinen malli (Semantic Data Model), joka on mahdollista toteuttaa fyysisen mallin päälle kytkemään tekninen toteutus liiketoiminnan kieleen ja mittareihin. Tietomallinnuksenkin yhteydessä keskeistä on muistaa myös mallien dokumentointi eli metatiedon luominen sekä ylläpito.
Käsitemalli
Käsitteellinen tiedon mallintaminen (Conceptual Data Modeling) tai lyhyesti käsitemallinnus on keskeinen lähtökohta tietovaraston tai muun uuden IT-järjestelmän suunnittelussa ja vaatimusmäärittelyssä. Siinä IT-osaajat ja eri liiketoiminta-alueiden edustajat istuvat saman pöydän ääreen etsimään yhteisen kielen ja tavan puhua asioista. Tavoitteena on löytää kehitettävän järjestelmän kannalta keskeiset entiteetit, entiteettien väliset suhteet ja järjestelmän kannalta oleelliset liiketoimintaprosessit. Tuotantoympäristössä tällaisia entiteettejä voivat olla esim. "tuote", "työkalu", "tuotantokoneTuotantokone (Production machine). Fyysinen laite, jolla valmistetaan tuotteita" ja "tuotantotyöntekijä".
Käsitemallinnuksessa puhutaan liiketoiminnan kieltä, joka vasta myöhemmässä vaiheessa yhdistetään mm. tietokannoissa oleviin tietoihin. Teknisiin yksityiskohtiin ei vielä tässä vaiheessa mennä. Käsitemallinnuksessa määritellään, mitä kullakin käsitteellä tarkoitetaan ja mitä käsitteitä käytetään. Onko esim. "tuotantokoneTuotantokone (Production machine). Fyysinen laite, jolla valmistetaan tuotteita" sopiva käsite yrityksen kontekstissa vai pitäisikö käsitemallissa puhua mieluummin vaikka "kuormitusryhmästä" tai "työkeskuksesta". Tuotannossa työskenteleville tämän kaltaiset käsitteet voivat olla itsestään selviä, mutta vaikka IT-osaajille käsitteiden sisältö ja rajaukset vaativat selvennyksiä ja rajauksia. Käsitemallinnuksessa voidaan avata vaikka mitä "tuotantotilauksen työvaihe kuormitetaan tuotantosolulle" tarkoittaa ja piirtää siitä kuvaaja.
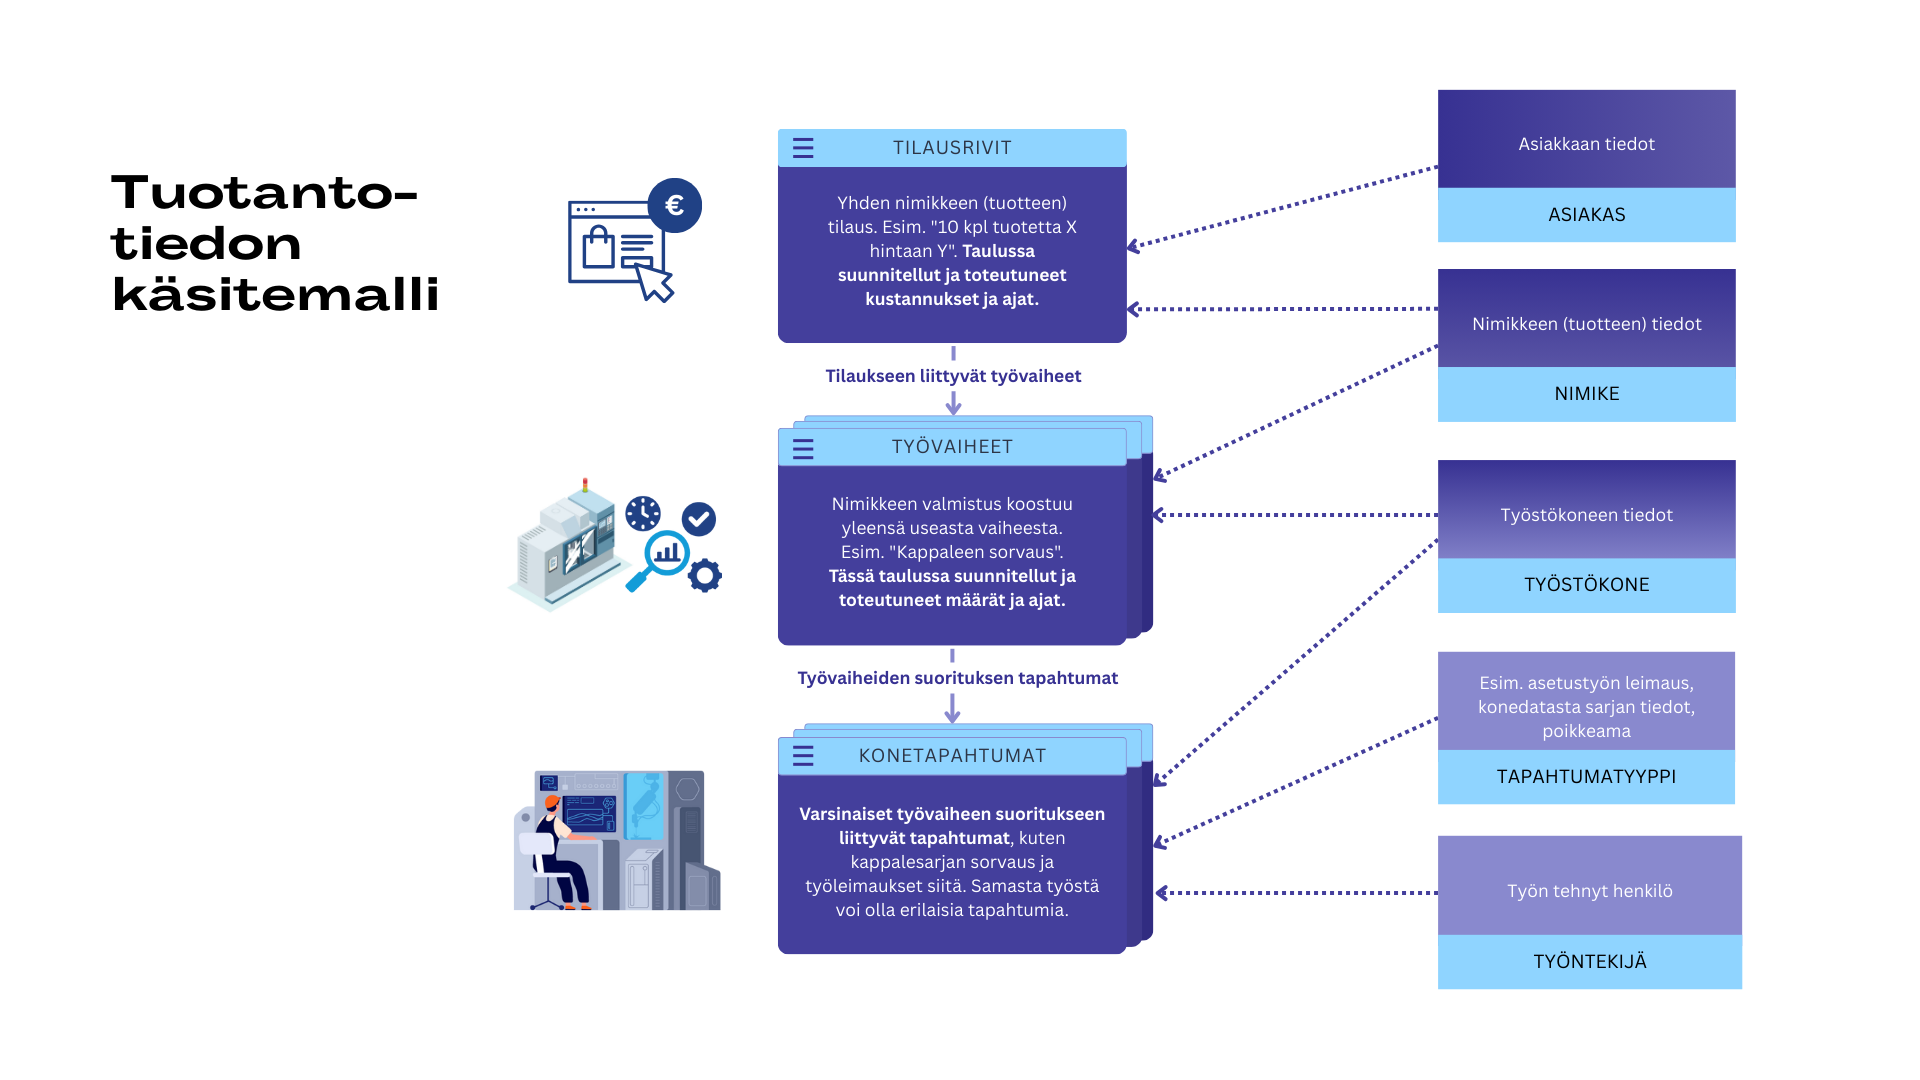
Käsitemallinnuksen lopputuloksena syntyy lista käytettävistä käsitteistä ja niiden synonyymeistä määritelmineen. Syntyy myös käsitteiden väliset yhteydet, jotka voidaan esittää esim. yksinkertaistetun ER-kaavion (Entity Relationship Diagram) avulla tai muutoin sopivalla esitysmuodolla. Alla on TUOVA-hankkeessa kehitetty käsitemalliKäsitemalli (Conceptual Data Model). Alustava liiketoimintalähtöinen kuvaus datasta ilman teknisiä yksityiskohtia. tuotantotiedon hallintaa varten.
Looginen tietomalli
Loogisessa tiedon mallintamisessa (Logical Data Modeling) käsitemallia aletaan tarkentaa ja se muutetaan teknisemmäksi rakenteelliseksi tietomalliksi. Entiteetit muutetaan tauluiksi, niille määritellään ominaisuudet (attribuutit), luodaan pää- ja vierasavaimet relaatioita varten, määritetään tietotyypit ja tehdään tarvittaessa tiedon normalisointia tai denormalisointia. Jos loogista tietomallia kehitetään tietovarastoa varten, valitaan käytetäänkö mallinnuksessa esim. tähtimallia (Star Schema) tai Data VaultData VaultTietovarastojen mallinnusmenetelmä, jossa data organisoidaan kolmeen pääkomponenttiin (hub, link, satellite), jotta voidaan integroida data useista lähteistä, säilyttää täydellinen historia ja mahdollistaa joustava kehitys. mallia pohjana. Analytiikan kannalta dimensiopohjainen tähtimalliTähtimalli (Star Schema). Tietovarastojen yhteydessä usein käytetty tietomalli, jossa yksi tai useampi faktataulu on yhdistetty kuvaaviin ulottuvuustauluihin suorien viiteavainten kautta. on paljon käytetty ja selkeä tietomallin muoto, joka on jo sellaisenaan liitettävissä BI-ohjelmistoihin.
Tietovarastoissa ja analytiikassa eniten käytetty tietomallin rakenne on ns. ”tähtimalliTähtimalli (Star Schema). Tietovarastojen yhteydessä usein käytetty tietomalli, jossa yksi tai useampi faktataulu on yhdistetty kuvaaviin ulottuvuustauluihin suorien viiteavainten kautta.” (star schema), jossa data jaetaan faktatauluihin (fact tables) ja ulottuvuustauluihin (dimensional tables). TähtimalliTähtimalli (Star Schema). Tietovarastojen yhteydessä usein käytetty tietomalli, jossa yksi tai useampi faktataulu on yhdistetty kuvaaviin ulottuvuustauluihin suorien viiteavainten kautta. on säilyttänyt suosionsa 90-luvulta lähtien sen selkeyden ja tehokkuuden vuoksi.
Tähtimallin ominaispiirteitä:
- Perusmuotoisessa tähtimallissa on yksi keskellä oleva faktatauluFaktataulu (Fact Table). Mitattavat arvot sisältävä taulu., joka sisältää mitattavat suureet (esim. määriä) ja linkitykset ympäröiviin ulottuvuustauluihin vierasavainten avulla. Rakenne on tähtimäinen, mistä malli on saanut nimensäkin.
- Faktataulukkoa ympäröivät ulottuvuustaulut, jotka kuvaavat dataa eri näkökulmista kuten aika, tuote ja asiakas. Ulottuvuustaulut liittyvät faktatauluun avainten avulla.
- Ulottuvuustaulut ovat tyypillisesti denormalisoituja rakenteen yksinkertaistamiseksi ja suorituskyvyn parantamiseksi. Ei tarvitse tehdä monimutkaisia taulujen välisiä liitoksia.
- TähtimalliTähtimalli (Star Schema). Tietovarastojen yhteydessä usein käytetty tietomalli, jossa yksi tai useampi faktataulu on yhdistetty kuvaaviin ulottuvuustauluihin suorien viiteavainten kautta. on optimoitu analytiikkaa ja raportointia varten. Mahdollistaa nopeat kyselyt sekä tiedon koonnin (aggregointi).
- Rakenne on intuitiivinen ja helppo ymmärtää eri tahoille, kuten tekniikan ja liiketoiminnan edustajille.
- Dataa voidaan tarkastella eri ulottuvuuksien kautta (esim. katteet asiakasta, tuotetta tai ajanjaksoa kohti).
Tähtimallista on johdettu lumihiutalemalliLumihiutalemalli (Snowflake Schema). Tähtimalli, jossa dimensiotaulut on normalisoitu eli pilkottu alidimensioiksi. (Snowflake Schema) ja galaksimalliGalaksimalli (Galaxy Schema). Tunnetaan myös nimellä "Fact Constellation". Tähtimalli, jossa useampi faktataulu jakaa yhteisiä ulottuvuustauluja. (Galaxy Schema). Lumihiutalemallissa ulottuvuustaulut on normalisoitu pidemmälle eli ulottuvuustauluilla voi olla omia alataulujaan. Galaksimallissa puolestaan voi olla useampia faktatauluja, jotka käyttävät samoja ulottuvuustauluja. Monesti puhutaan vain tähtimallista, vaikka todellisuudessa kyse voi olla lumihiutalemallista tai galaksimallista.
Looginen malli ei ota vielä kantaa toteutusteknologiaan eli vaikka tietokantaratkaisun yksityiskohtiin. Loogisen mallin voi myös esittää esimerkiksi ER-kaaviona.
Fyysinen tietomalli
Fyysisessä tietomallissa looginen tietomalliLooginen tietomalli (Logical Data Model). Käsitemallia tarkempi kuvaus, jossa määritellään entiteetit (taulut), attribuutit (sarakkeet), tietotyypit ja relaatiot. jatkotyöstetään vietäväksi tietoalustalle eli käytännössä muodostetaan toteutettava tietokantarakenne. Taulut ja sarakkeet nimetään yhtenäisesti, tietotyypit tarkennetaan, avaimet luodaan ja optimoidaan mallin suorituskykyä. Luodaan ns. tietokannan skeema (Schema) sekä esim. tietokannan SQL-luontilauseet. Toteutustapa on jossain määrin riippuvainen tietokannasta/tietoalustasta. Myös fyysinen tietomalliFyysinen tietomalli (Physical Data Model). Konkreettinen toteutus tietokannassa. Määrittää tarkat taulujen ja sarakkeiden nimet, indeksit, avaimet, rajoitteet ja muistitilan. voidaan esittää ER-kaaviona.
Semanttinen tietomalli
Tietomallinnuksessa ja tietovarastossa tieto viedään yleensä fyysiseen tietomalliin eli tietokannan toteutukseen saakka. Semanttinen mallintaminen (Semantic Modeling) nähdään tästä prosessista erillisenä, vaikka sillä on vahvat liittymäpinnat. Semanttinen tietomalli (Semantic Data Model) tai semanttinen kerrosSemanttinen kerros (Semantic Layer). Abstraktiokerros tietovaraston ja käyttäjien välillä, jossa määritellään liiketoimintakäsitteet kuten "myynti" tai "kannattavuus". Varmistaa, että kaikki analysoivat dataa samalla tavalla. (Semantic Layer) ovat analytiikassa hieman tuoreempia ja sisällötään vakiintumattomia käsitteitä, jotka ovat vahvasti kytköksissä eri toteutusalustoihin.
Semanttisen mallinnuksen voi nähdä käsitemallinnuksen jatkona tai laajennuksena, jossa palataan käsitemallinnuksen liiketoimintakieleen ja linkitetään fyysinen tietomalliFyysinen tietomalli (Physical Data Model). Konkreettinen toteutus tietokannassa. Määrittää tarkat taulujen ja sarakkeiden nimet, indeksit, avaimet, rajoitteet ja muistitilan. suoraan liiketoiminnan käsitteisiin ja prosesseihin. Se täydentää käsitteellistä, loogista ja fyysistä mallintamista yhdistämällä tekniset tietorakenteet ymmärrettäviin käsitteisiin, mittareihin ja liiketoimintasääntöihin.
Monille semanttinen tietomalli on tuttu Power BI käsitteistöstä. Siinä yhteydessä semanttinen malli toimii aktiivisena välikerroksena tietokantataulujen ja visualisointien sekä mittareiden välillä. Käytännössä Power BI:ssä toimitaan semanttisen tietomallin eikä suoraan tuotujen tietokantataulujen kanssa. Semanttinen malli sisältää mm. taulut, yhteydet tietolähteisiin ja tietokantataulujen välillä, lasketut sarakkeet sekä mittarit, muut DAX-tietomuunnokset (liiketoimintalogiikka), tiedon esitysmuodot, rivitasoisen tiedon suojaamisen, nimeämistavat sekä metadatan.
Eri tietoalustoilla sekä BI-työkaluissa on muita vastaavan kaltaisia semanttisia mallejaan erilaisilla ominaisuuksilla. Esimerkiksi suoraan tietoalustan päälle rakennettu semanttinen malli mahdollistaa erilaisten BI-työkalujen liittämisen niin, ettei esimerkiksi mittareita tarvitse joka kerta määrittää uudelleen. Semanttinen malli mahdollistaa myös tekoälypohjaiset analytiikkaratkaisut, koska semanttisessa mallissa käsitteistö ja liiketoimintasäännöt ovat määritelty LLM-tekoälylle ymmärrettävällä tasolla. Semanttisten mallien luomisen merkityksen voidaankin nähdä kasvavan jatkossa.
Tietomallien dokumentointi eri mallinnuksen vaiheissa on tärkeää. MetatietoMetatieto (Metadata). Kuvailevaa tietoa datasta, kuten rakenne, alkuperä, formaatti, merkitys ja käyttöoikeudet. Metatieto mahdollistaa datan löytämisen, ymmärtämisen ja hallinnan. (tai metadata) on tietoa tiedosta eli kuvailevaa ja määrittelevää lisätietoa. Metatiedoissa voidaan kuvata mistä data tulee, mitä se tarkoittaa, miten usein se päivittyy, miten sitä käytetään, miten se on laskettu (jos liittyy laskentaa) ja mitä muuta huomioitavaa kyseiseen dataan liittyy. Ilman metadataa ei tiedetä mm. milloin tieto on päivitetty, mistä se on tullut ja voiko siihen luottaa.
Metatietoa syntyy tietomallinnuksen eri vaiheissa. Käsitemallinnuksen yhteydessä keskeistä on mm. määritellä käsitteet rajauksineen. Loogiseen tietomalliin on hyvä kuvata jo tarkemmin mm. tiedon lähteet, mitä lasketaan tietoihin liittyy ja miten tietoa on ajateltu käytettävän. Fyysisen tietomallin kuvauksen yhteydessä oleellisia ovat mm. tietokannan skeemat. Monet tietoalustat mahdollistavat metatietojen liittämisen vaikka suoraan tietokannan tauluihin.
DatakatalogiDatakatalogi (Data Catalog). Työkalu tai palvelu, joka kokoaa metatiedon yhteen paikkaan ja auttaa löytämään, ymmärtämään ja hyödyntämään organisaation dataa. Sisältää usein datan kuvaukset, omistajat ja käyttöoikeudet. (Data Catalog) on keskistetty hakemisto kaikista yrityksen tietovarannoista. Se kokoaa yhteen metatietoa mm. kaikista yrityksen käytettävissä olevista dataseteistä ja raporteista. Yksi datakatalogin osio voisi koostua vaikka tietovarastosta ja siinä käytetyistä tietomalleista. Katalogissa keskeistä on määrittää myös datan omistajuudet ja käyttöoikeudet.
Miten tieto saadaan tietovarastoon?
Kun on valittu tietovaraston toteutustapa ja tehty tiedon mallinnus aina fyysiseen malliin asti, on haasteena saada tieto liikkumaan luotettavasti eri lähteistä tietovarastoon haluttuun muotoon. Tämä voi olla teknisesti haastava vaihe monien mahdollisten karikoiden kanssa.
Kaksi keskeistä tietovaraston tietoputken toteutustapaa ovat jo aiemmin mainitut ETL- (Extract–Transform–Load) ja ELT-prosessit (Extract–Load–Transform). Näiden ero on siinä, missä vaiheessa tiedon muuttaminen tapahtuu. Tietovarastoinnin yhteydessä perinteisempi ETL-prosessiETL-prosessi (Extract–Transform–Load). Prosessi, jossa data kerätään lähteistä, muokataan analysoitavaan muotoon ja tallennetaan tietovarastoon. keskittyy datan suorempaan muuttamiseen, jolloin tietovarastoon viedään lähinnä jo käsiteltyä tietoa. ELT-prosessissa tietojen käsittely tapahtuu kerroksittain tietoalustan päällä. ETL vaatii tarkemmat etukäteismäärittelyt muunnoksille eikä ole niin joustava kuin ELT. Käytännössä myös ETL-prosessissa tietojen muuntaminen voi tapahtua vaiheittain ja välivaiheiden tuotokset aina raakadatasta asti voivat myös sijaita tietovarastossa tai muussa tallennuspaikassa. Käytännön toteutuksissa voidaan yhdistellä molempien mallien piirteitä.
Tietoputkien toteutukseen on käytettävissä monia erilaisia työkaluja ja lähestymistapoja. Työkalujen valintaan vaikuttaa suoraan tiedon määrä ja päivittymistiheys. Volyymiltaan suuren reaaliaikaisesti päivittyvän datavirran hallintaan soveltuvat aivan eri työkalut kuin vaikka säännöllisesti päivittyvän PDF-raportteja sisältävän kansion käsittelyyn. Myös valittu tietoalustaTietoalusta (Data Platform). Teknologinen kokonaisuus, joka tarjoaa työkalut datan keruuseen, tallennukseen, prosessointiin ja analysointiin. voi rajata työkaluvalikoimaa jonkin tarjoajaan valikoimaan. Ehkä voi helpottaa lähteä rajaamaan toteutustapoja tietovaraston erilaisia käyttötapauksia ja niiden työkaluja miettimällä.
Alla oleva kuva vuodelta 2025 antaa suppean katsauksen silloin eri tarkoituksiin tarjolla olevista avoimen lähdekoodin datatyökaluista. Kaupallisten toimijoiden lista on vielä laajempi. Erilaisten työkalujen markkina on niin laaja, että juuri omaan käyttötarkoitukseen ja tarpeisiin sopivien työkalujen valinta on haastavaa. Markkinoille tulee jatkuvasti uusia hypetettyjä työkaluja ja valintoja kannattaisi pyrkiä tekemään mieluummin tarpeiden kuin sen hetkisten trendien mukaan.
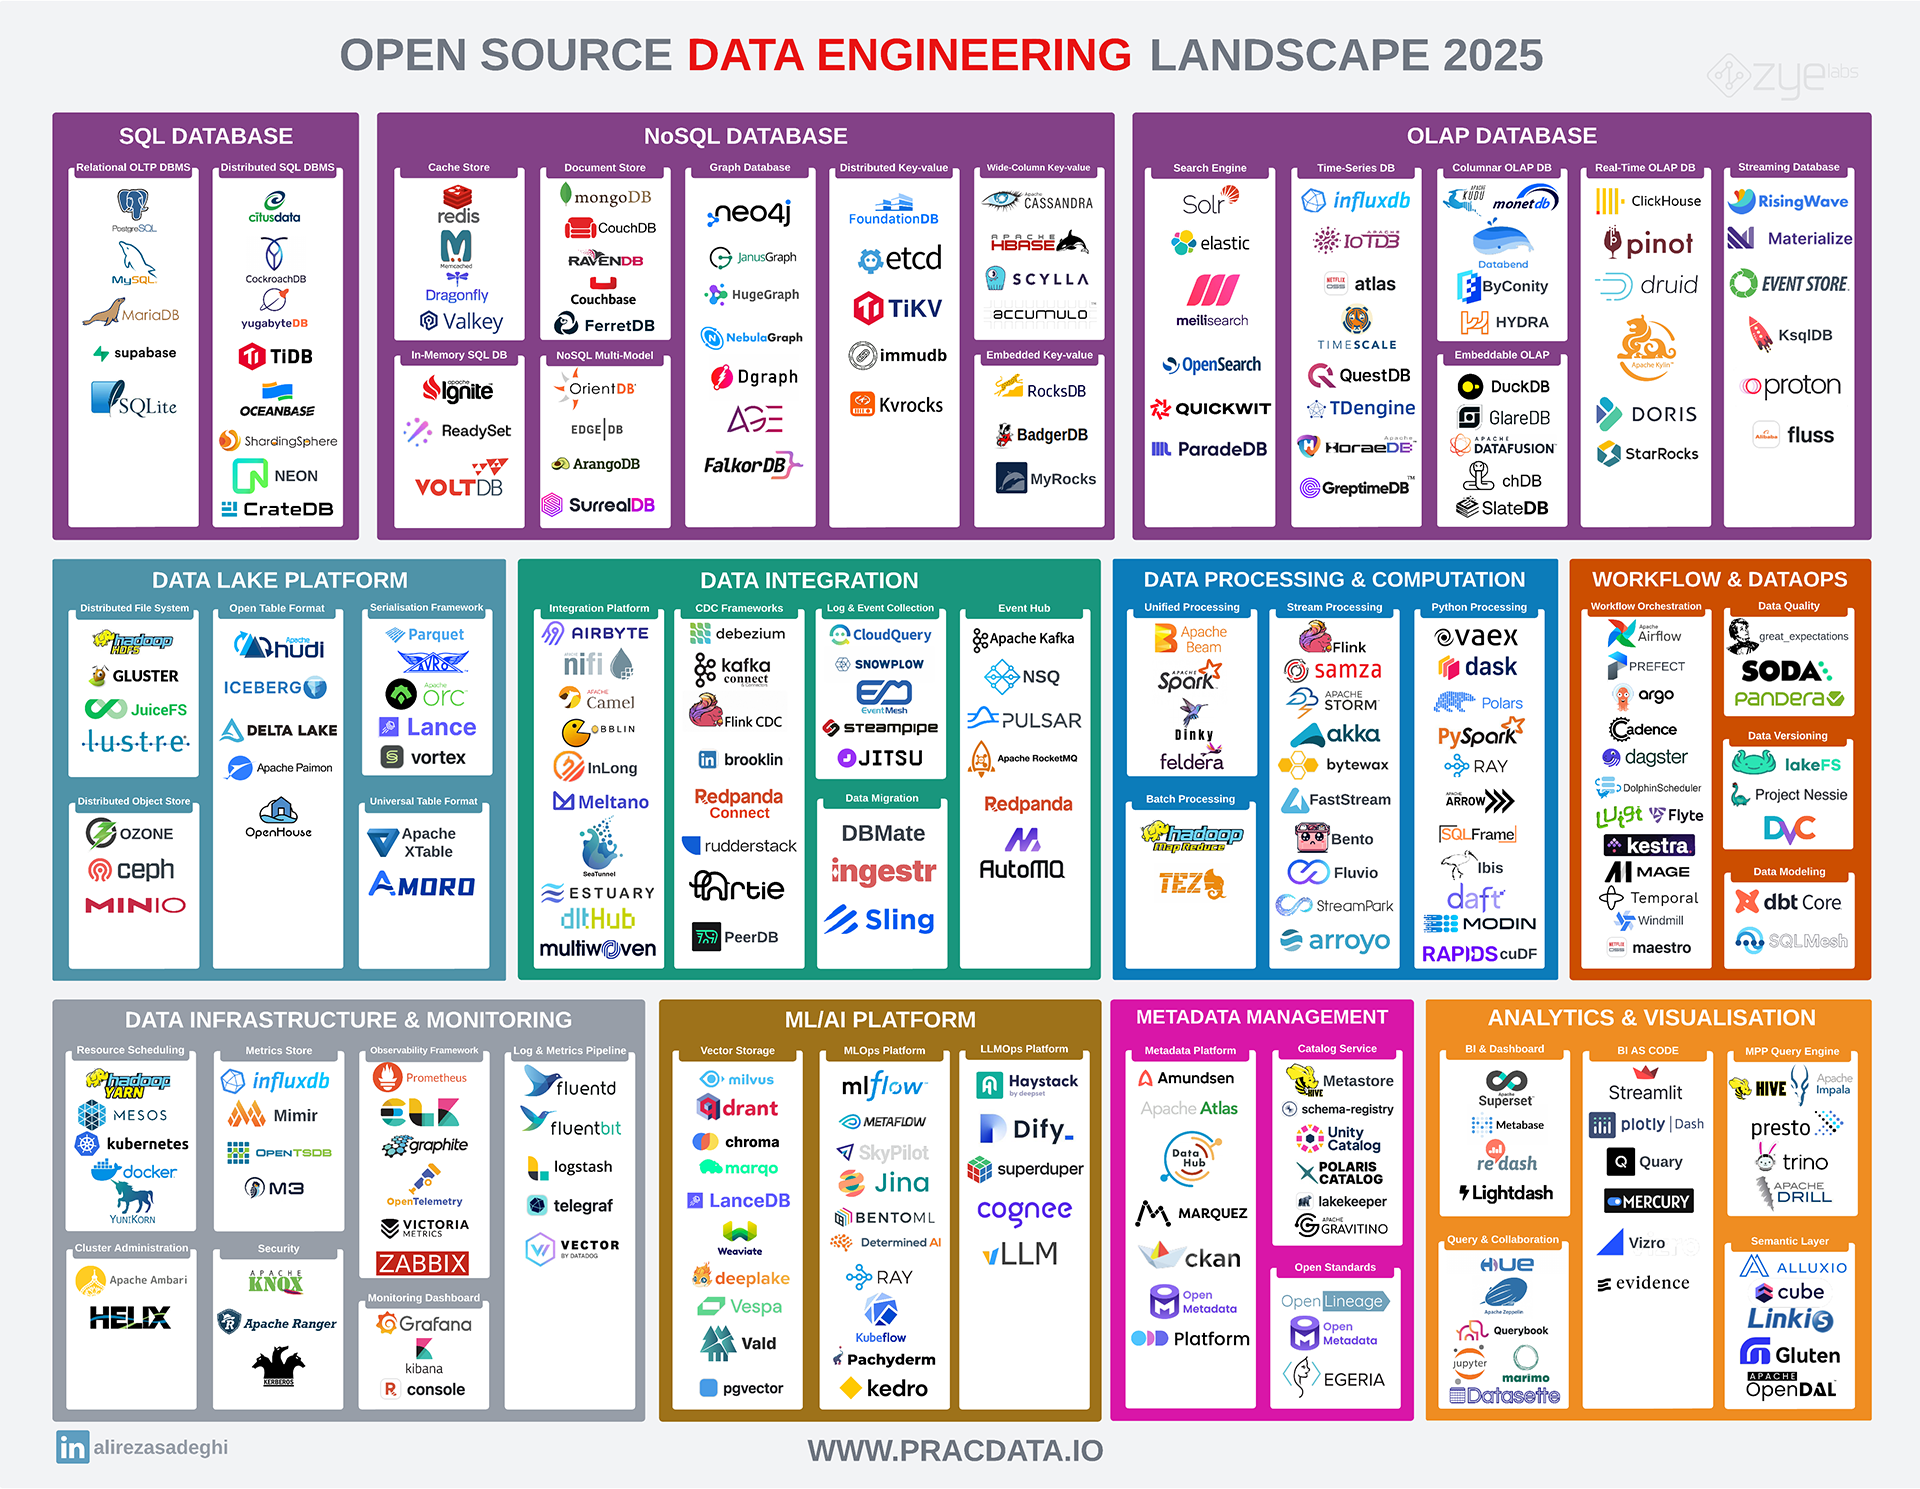
Esimerkkejä erilaisista mahdollisesti tarvittavista työkaluista:
- Tiedon tallennus: Tietovaraston "tietokanta" on yksi keskeisistä valinnoista. Tavalliset relaatiopohjaiset tietokannat, kuten PostgreSQL tai SQL Server, riittävät varsin hyvin kevyeen toteutukseen ja näitä voi ajaa joko yrityksen sisällä tai pilvessä. Pilvipohjaisia tietovarastoratkaisuja rakennetaan nykyään usein hybridiarkkitehtuureilla (Data Lakehouse), josta esimerkkejä on mm. Microsoft Fabric Warehouse, Databricks, Snowflake ja BigQuery. Data-analytiikassa myös mm. DuckDB on monessa käytössä hyödyllinen työkalu.
- Tiedon poiminta ja siirtäminen: Reaaliaikaisten tietovirtojen hallintaan käytettäviä työkaluja ovat mm. Apache Spark, Apache Kafka ja Azure Stream Analytics.
- Tietojen muuntaminen: Tiedon muunnoksiin käytettäviä työkaluja ovat mm. dbt Core, SQL-skriptit ja Python. Välitaulujen tallennuksessa esim. Parquet on toimiva tiedostomuoto.
- Työnkuljujen ajastus ja valvonta: Työnkulkujen orkestrointiin ja ajastukseen laajalti käytettyjä työkaluja ovat mm. Apache Airflow, Dagster, Prefect ja cron.
- Tietomallinnus: Tietomallinnuksessa käytettäviä työkaluja ovat mm. erwin Data Modeler, dbdiagram.io ja SqlDBM.
- Metatiedon ja dokumentaation hallinta: Dokumentoinnissa ja metatiedon hallinnassa käytettäviä työkaluja ovat mm. dbt docs, DataHub, OpenMetadata ja OKF.
- Raportointi ja analytiikka: Raportointi- ja analytiikkatyökaluista tunnettuja ovat esim. Excel, Power BI ja Tableau. Avoimen lähdekoodin vaihtoehtoja ovat mm. R, Python, Metabase ja Superset.
- Versionhallinta ja käyttöönotto: Tavallisia työkaluja ovat mm. Docker ja Git.
Työkaluja ei kannata valita yksittäin ennen kokonaisarkkitehtuurin ja ylläpitomallin määrittelyä. Yksi alusta voi kattaa useita tehtäviä, kun taas kevyt ratkaisu voi koostua tietokannasta, muunnosskripteistä, ajastuksesta, versionhallinnasta ja raportointityökalusta.
Lähteitä ja lisätietoja tietoalustoista ja tietomallinnuksesta
-
Kimball, R. ja Ross, M.: The Data Warehouse Toolkit, 3rd Edition: Käytännönläheinen klassikko dimensionaaliseen tietovarastomallinnukseen. Esittelee tähtimallit, faktataulut, dimensiot sekä yleiset tietovarastoinnin mallinnusratkaisut lukuisien esimerkkien avulla.
-
Kimball, R. ym.: The Data Warehouse Lifecycle Toolkit, 2nd Edition: Kattaa tietovarastoprojektin koko elinkaaren liiketoimintatarpeiden tunnistamisesta toteutukseen, käyttöönottoon ja ylläpitoon.
-
Linstedt, D. ja Olschimke, M.: Building a Scalable Data Warehouse with Data VaultData VaultTietovarastojen mallinnusmenetelmä, jossa data organisoidaan kolmeen pääkomponenttiin (hub, link, satellite), jotta voidaan integroida data useista lähteistä, säilyttää täydellinen historia ja mahdollistaa joustava kehitys. 2.0: Syvällisempi teos Data VaultData VaultTietovarastojen mallinnusmenetelmä, jossa data organisoidaan kolmeen pääkomponenttiin (hub, link, satellite), jotta voidaan integroida data useista lähteistä, säilyttää täydellinen historia ja mahdollistaa joustava kehitys. 2.0 -mallinnuksesta ja skaalautuvan tietovaraston rakentamisesta. Soveltuu erityisesti laajoihin ja monimutkaisiin tietointegraatiokokonaisuuksiin.
-
Ari Hovi: Blogi: Pitkäaikainen suomalainen asiantuntijablogi tietovarastoinnista, tietomallinnuksesta, tiedolla johtamisesta, data-arkkitehtuurista ja analytiikasta.
-
Ari Hovi: Tiedon mallinnuksen tasot: Esitys käsitemallin, loogisen tietomallin ja fyysisen tietomallin eroista sekä niiden roolista tietojärjestelmien suunnittelussa.
-
Ari Hovi: Tietovarastot uusiksi: Suomalainen keskustelunavaus evolutiivisesta tietovarastoarkkitehtuurista, infokerroksesta, leveistä collection-tauluista, AI:n SQL-generoinnista ja metadatan merkityksestä.
-
Raudaskoski, N.: Modernin tietovaraston suunnitteluperiaatteet: Tampereen yliopiston diplomityö modernien tietovarastojen suunnittelusta. Tarkastelee erityisesti liiketoimintalähtöistä kehittämistä, iteratiivisuutta ja nykyaikaisia tietovarastoratkaisuja.
-
Arvola, M.: BI- ja tietovarastoprojektien arkkitehtuurivalinnat: Tampereen yliopiston diplomityö BI- ja tietovarastoprojektien arkkitehtuurivalinnoista, niiden taustatekijöistä ja käytännön soveltamisesta.
-
DAMA International: DAMA-DMBOK: Virallinen lähde DAMA-DMBOK-viitekehykseen. Sisältää datanhallinnan osa-alueet, tietovarastoinnin, metadatahallinnan, tietomallinnuksen ja data governancen keskeiset käsitteet.
-
Dataversity: Laaja tietovarastoinnin, metadatahallinnan, tietomallinnuksen ja data governancen asiantuntijasivusto. Sisältää artikkeleita, tutkimuksia, webinaareja ja koulutusmateriaalia.
-
Scalefree Knowledge Base: Laaja kokoelma artikkeleita Data VaultData VaultTietovarastojen mallinnusmenetelmä, jossa data organisoidaan kolmeen pääkomponenttiin (hub, link, satellite), jotta voidaan integroida data useista lähteistä, säilyttää täydellinen historia ja mahdollistaa joustava kehitys. -mallinnuksesta, tietovarastoarkkitehtuureista ja modernien tietovarastojen toteutuksesta.
-
Databricks Blog: Yksi keskeisimmistä modernien data-alustojen lähteistä. Käsittelee lakehouse-arkkitehtuuria, analytiikkaa, data engineeringiä ja tietovarastojen tulevaisuutta.
-
Snowflake Blog: Pilvipohjaisen tietovarastoinnin, data-alustojen ja analytiikkaratkaisujen käytännön toteutuksia ja arkkitehtuurimalleja.
-
DataArchitect Studio: Kimball vs Inmon: Katsaus Kimballin ja Inmonin tietovarastofilosofioihin. Auttaa ymmärtämään tietovarastoarkkitehtuurien kehityshistoriaa ja keskeisiä suunnitteluperiaatteita.
-
DataArchitect Studio: The Medallion Architecture, Reconsidered: Artikkeli mitaliarkkitehtuurin merkityksestä, ongelmista ja yhteydestä semanttiseen kerrokseen.
-
Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics, CIDR 2021: Tutkimuspaperi lakehouse-arkkitehtuurista, avoimista tiedostomuodoista, metadata layerista, ACID-transaktioista ja ML- sekä BI-kuormien yhdistämisestä.
-
Microsoft Learn: Understand Star Schema and the Importance for Power BI: Microsoftin suositus tähtimallin käytöstä analytiikassa. Selittää faktataulujen, ulottuvuustaulujen ja dimensionaalisen mallinnuksen periaatteet käytännönläheisesti.
-
Microsoft Learn: Power BI Semantic Model Designer Documentation: Tietopaketti semanttisista malleista, relaatioista, DAX-laskennasta ja analytiikkamallien optimoinnista.
-
Atlan: DAMA DMBOK Framework: An Ultimate Guide for 2026: Johdanto DAMA-DMBOK-viitekehykseen. Yleiskatsaus datan hallinnan osa-alueisiin, kuten tietomallinnukseen, metadataan, tietojen laatuun, tietovarastointiin ja data governanceen.
-
What is the medallion lakehouse architecture?, Databricks Docs: Databricksin ohje bronze, silver ja gold -kerroksiin, datan laadun asteittaiseen parantamiseen sekä gold-kerroksen dimensionaaliseen mallinnukseen.
-
Dimensional modeling in Fabric Data Warehouse, Microsoft Learn: Virallinen Microsoft Fabric -ohje dimensionaaliseen mallinnukseen, faktatauluihin, dimensiotauluihin, tähtimalliin ja Power BI -semanttisen mallin perustaan.
-
Martin Fowler: Data MeshData meshHajautettu arkkitehtuuri, jossa data omistetaan ja hallitaan liiketoiminta-alueittain. Principles and Logical Architecture: Tunnettu artikkeli data meshData meshHajautettu arkkitehtuuri, jossa data omistetaan ja hallitaan liiketoiminta-alueittain. -ajattelusta ja hajautetusta datan omistajuudesta. Hyödyllinen erityisesti modernien data-arkkitehtuurien ymmärtämisessä.
-
dbt Semantic Layer, dbt Developer Hub: Virallinen dbt-lähde metriikoiden keskitettyyn määrittelyyn mallinnuskerroksessa, self-service-käyttöön ja metric definition -yhtenäisyyteen eri työkalujen välillä.
-
YAML specification for semantic views: Snowflaken käytännön määrittelylähde semantic view -YAMLille, kuten logical tables, dimensions, facts, metrics, relationships, verified queries ja governance-tägit.
-
Semantic Layer Architecture: Components, Design Patterns, and AI Integration: Databricksin tekninen blogi siitä, miten semanttinen kerrosSemanttinen kerros (Semantic Layer). Abstraktiokerros tietovaraston ja käyttäjien välillä, jossa määritellään liiketoimintakäsitteet kuten "myynti" tai "kannattavuus". Varmistaa, että kaikki analysoivat dataa samalla tavalla. toimii LLM- ja agenttikäytössä, erityisesti mittareiden, synonyymien, metadata governance -kerroksen ja guardrailien kannalta.
-
Active Metadata Management: Complete 2026 Guide: Laaja lähde active metadata -ajatteluun, lineage-propagointiin, AI-agenttien kontekstiin, governance automationiin ja context layer -keskusteluun.
-
Data architecture for AI agents: Microsoftin arkkitehtuuri AI-agenttien data-alustaan, OneLakeen, governed data products -ajatteluun, retrieval-strategioihin, RAGiin ja MCPMCP (Model Context Protocol). Rajapintamalli, jolla sovellukset ja tietovarastot voivat välittää kontekstuaalista tietoa mm. kielimalleille (LLM) niiden toiminnan ohjaamiseksi.-valintoihin.
Tekijät:
- Sivun pääkirjoittaja: Jesse Honkanen, TKI-asiantuntija, Savonia-amk
- Sisällön tarkistukseen ja täydennyksiin osallistunut muu TUOVA-hankkeen henkilöstö sekä toimituskunta.
Sisällön tuotannossa on käytetty apuna tekoälytyökaluja (mm. Copilot) kieliasun yhtenäistämisessä, käsitteiden selittämisessä, tiivistelmissä ja joidenkin osioiden kirjoittamisessa. Hankehenkilöstö on tarkistanut tekoälyn tuotokset ennen julkaisua.
TUOVA-hankkeen tekemät kuvaajat ja sarjakuvat hahmoineen on toteuttanut pääosin Emmi Paananen yhteistyössä muun hankehenkilöstön kanssa. Muualta otettujen kuvituskuvien ja kuvaajien yhteydessä on mainittu lähde.
Lisenssi: Tekstit ja hankkeen tekemät kuvat on julkaistu CC BY-SA 4.0 lisenssillä.
Sivun alkuperäinen julkaisupäivämäärä: 24.8.2026
Tällä sivulla käytiin läpi yleisesti tietovaraston käsitettä, hyötyjä ja kehityssuuntia. Seuraavalla sivulla päästään tietovaraston käytännön suunnitteluun ja toteuttamiseen esimerkkien kautta.