Tietovaraston toteutus käytännössä
Aiemmalla sivulla saitte peruskäsityksen tietovarastosta ja sellaisen toteutuksen mahdollisista hyödyistä. Tällä sivulla kerrotaan esimerkin kautta TUOVA-hankkeessa kehitetystä tuotantotiedon tietomallista ja sen käytännön toteutuksesta tietovarastoksi. Toteutuksessa tehtyjä valintoja sekä saatuja oppeja avataan. Sivun tiedoista voi olla hyötyä yrityksen tietomallin ja tietovarastototeutuksen suunnittelussa.
Esimerkki tietovaraston suunnittelusta
TUOVA-hankkeessa (2024-2026) kehitettiin keinoja tuotantodatan hyödyntämiseen valmistavan teollisuuden yritysten kehittämisessä ja johtamisessa. Hankkeessa tutkittiin ja testattiin monenlaisia asioita, mutta yksi keskeisistä oli yleiskäyttöisen tietomallin kehittäminen ja siihen liittyvät mittaristo- ja tietovarastototeutukset.
TUOVA-hankkeen eteneminen tietovarastokehityksen näkökulmasta:
- Hankkeessa mukana olleiden koneistavien yrityksien kanssa pidettiin alkuhaastatteluja, joissa selvitettiin tietotarpeita ja usein esiin nousevia haasteita.
- Yrityshaastattelujen perusteella esiin nousi kolme keskeistä tuotannon kehittämisen aluetta: kannattavuus, tehokkuus ja laatu.
- Käsitemallinnusta tehtiin lähinnä hankkeen sisäisissä keskusteluissa tuotantotiedon hyödyntämisessä erityisesti kannattavuuden ja tuotannon tehokkuuden näkökulmasta.
- Yhdestä yrityksestä saadun vanhan ERP-järjestelmän datan pohjalta aloitettiin hahmottelemaan loogista tietomallia, jolla voitaisiin vastata monenlaisiin kannattavuuteen ja tehokkuuteen liittyviin tietotarpeisiin.
- Hankkeen data-analyytikkoData-analyytikko (Data Analyst). Analysoi dataa ja tuottaa raportteja. pseudonymisoi saadun ERP-datan ja muutti sen tietomallin mukaiseksi. Data havaittiin monilta osin puutteelliseksi, mutta riittäväksi demototeutuksiin.
- Hankkeessa työskennellyt datainsinööriData-insinööri (Data Engineer). Vastaa datan keruusta ja tietoputkista. teki muutamia pilvipohjaisia testitoteutuksia, joissa mm. tehtiin demodatan pohjalta ETL-prosessiETL-prosessi (Extract–Transform–Load). Prosessi, jossa data kerätään lähteistä, muokataan analysoitavaan muotoon ja tallennetaan tietovarastoon. tiedon käsittelyyn ja vientiin pilvipohjaiseen tietovarastoon. Tekniikkana käytettiin Kubernetes-ympäristössä pyörineen Airflow:n päällä ajettuja vaiheittain eteneviä Python-skriptejä ja tietovarastona Snowflakea.
- Hankeessa kehitettiin demodatan pohjalta myös Power BI raportti, johon määritettiin mittaristoa tuotannon kannattavuuden ja tehokkuuden seurantaan. Mittaristosta ja raportista lisätietoja täällä.
- Yhden yrityksen kanssa toteutettiin on-premises ratkaisu, jossa tietovarastoon tuotiin dataa sekä ERP-järjestelmästä että tuotantokoneista ja näitä tietoja yhdistämällä saatiin laskettua toteutuneita tuotantoaikoja sekä käyttöasteita. Tietomallia kehitettiin saatujen oppien pohjalta.
- Tietomalli siihen liittyvine mittareineen dokumentoitiin ja julkaistiin avoimesti käyttöön.
Tällä sivulla avataan käytettyjä teknologisia ratkaisuja ja arvioidaan niiden toimivuutta.
Esimerkkitietomalli tuotantotiedolle
Aiemmalla sivulla avattiin tietomallin ja erityisesti tähtimallin perusperiaatteita. Tietomallin avulla on tehty muutamia esimerkkitoteutuksia, joista yksi on kuvattu mittaristosivun yhteydessä.
Tietomalli on rakennettu dimensionaalisen mallinnuksen mukaisesti. Mallissa korostuu tuotantotiedon hyödyntäminen ja liittäminen tilauksiin tarjous- ja jälkilaskennan helpottamiseksi.
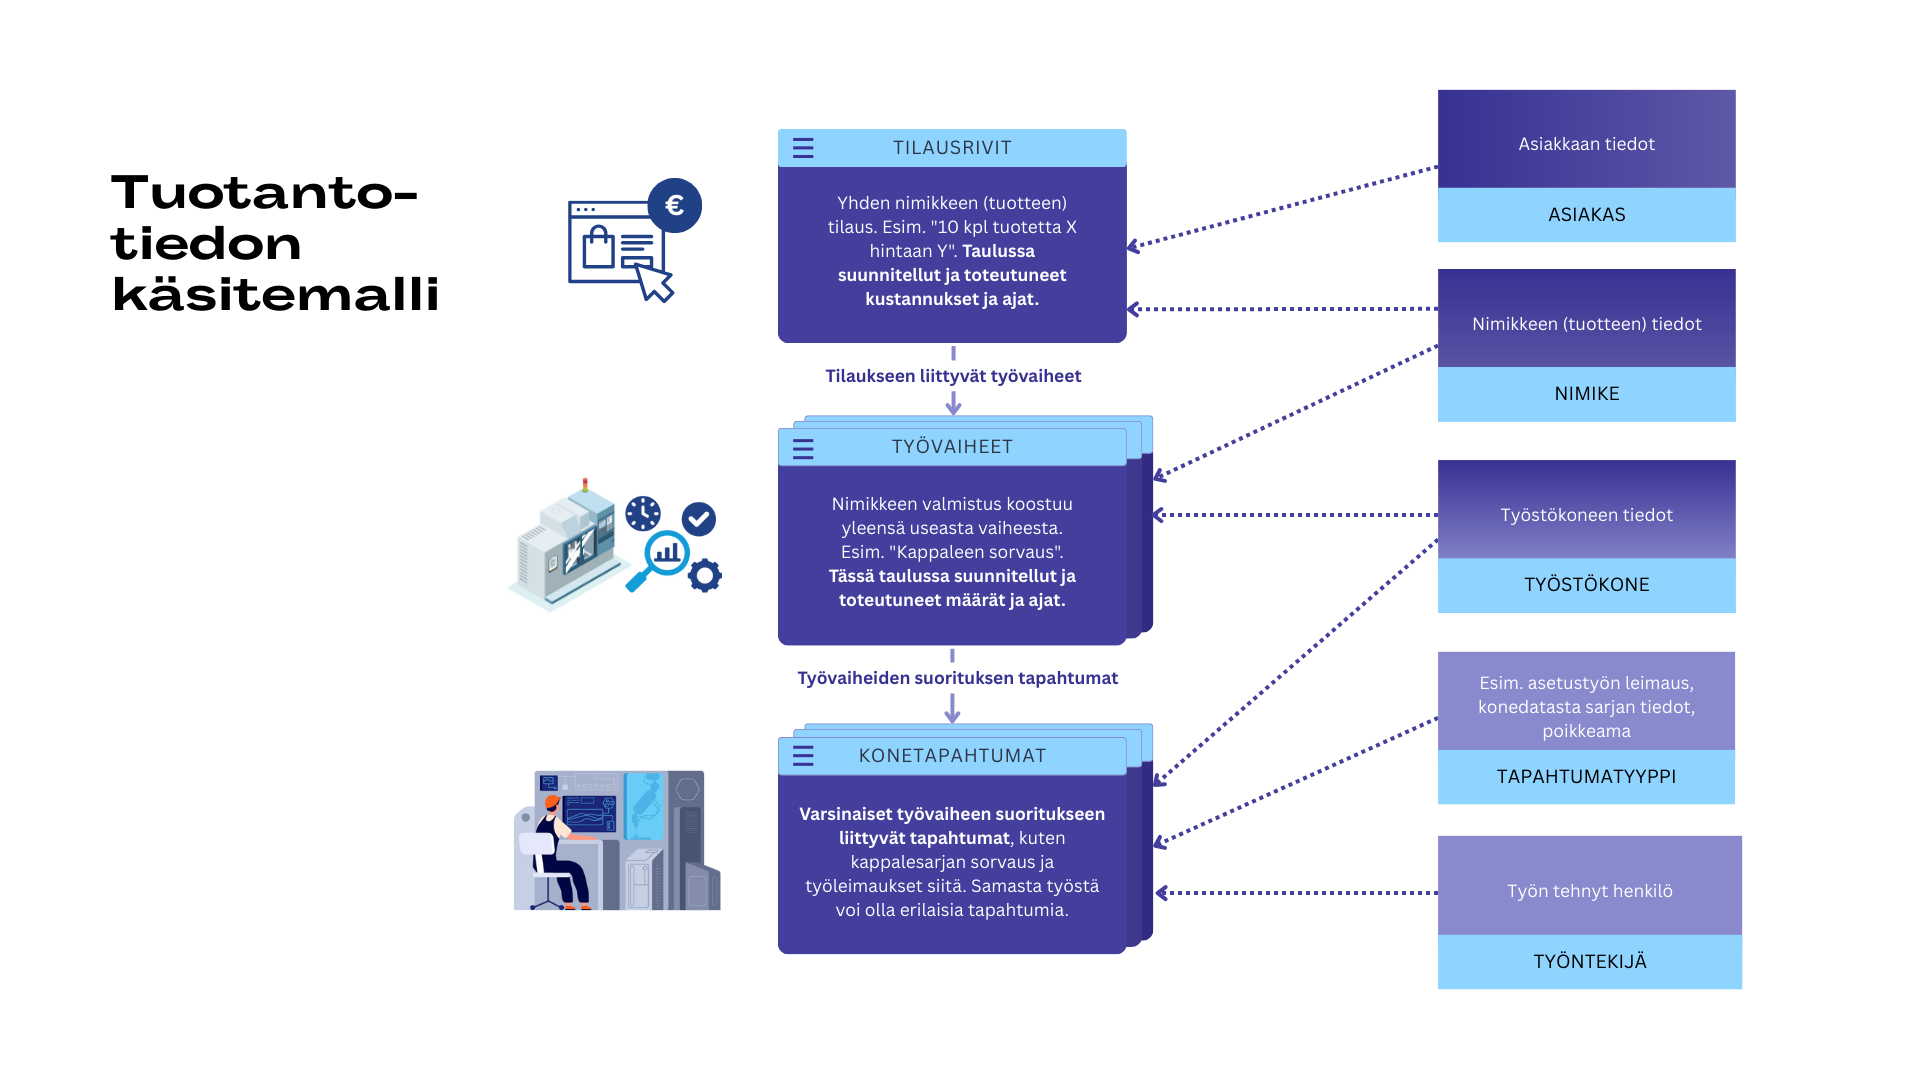
Tuotantotiedon tietomallimme perusrakenne koostuu kolmesta hierarkisesta faktataulusta ja niihin liittyvistä ulottuvuustauluista. Tietomallia voi soveltaa oman yrityksen oman tietomallin suunnittelussa pohjana. Tietomallia voidaan laajentaa ja muokata tarpeen mukaan.
Alta pääset Githubissa sijaitsevaan tietomallin dokumentaatioon. Dokumentaatio sisältää metadatan selitteineen, mittareiden määrittelyt ja taulujen luontilauseet.
Avaa tietomallin dokumentaatio
Tietovaraston esimerkkitoteutus
Alla on kuvattu TUOVA-hankkeessa yritykselle tehdyn tietovarastototeutuksen arkkitehtuuri.
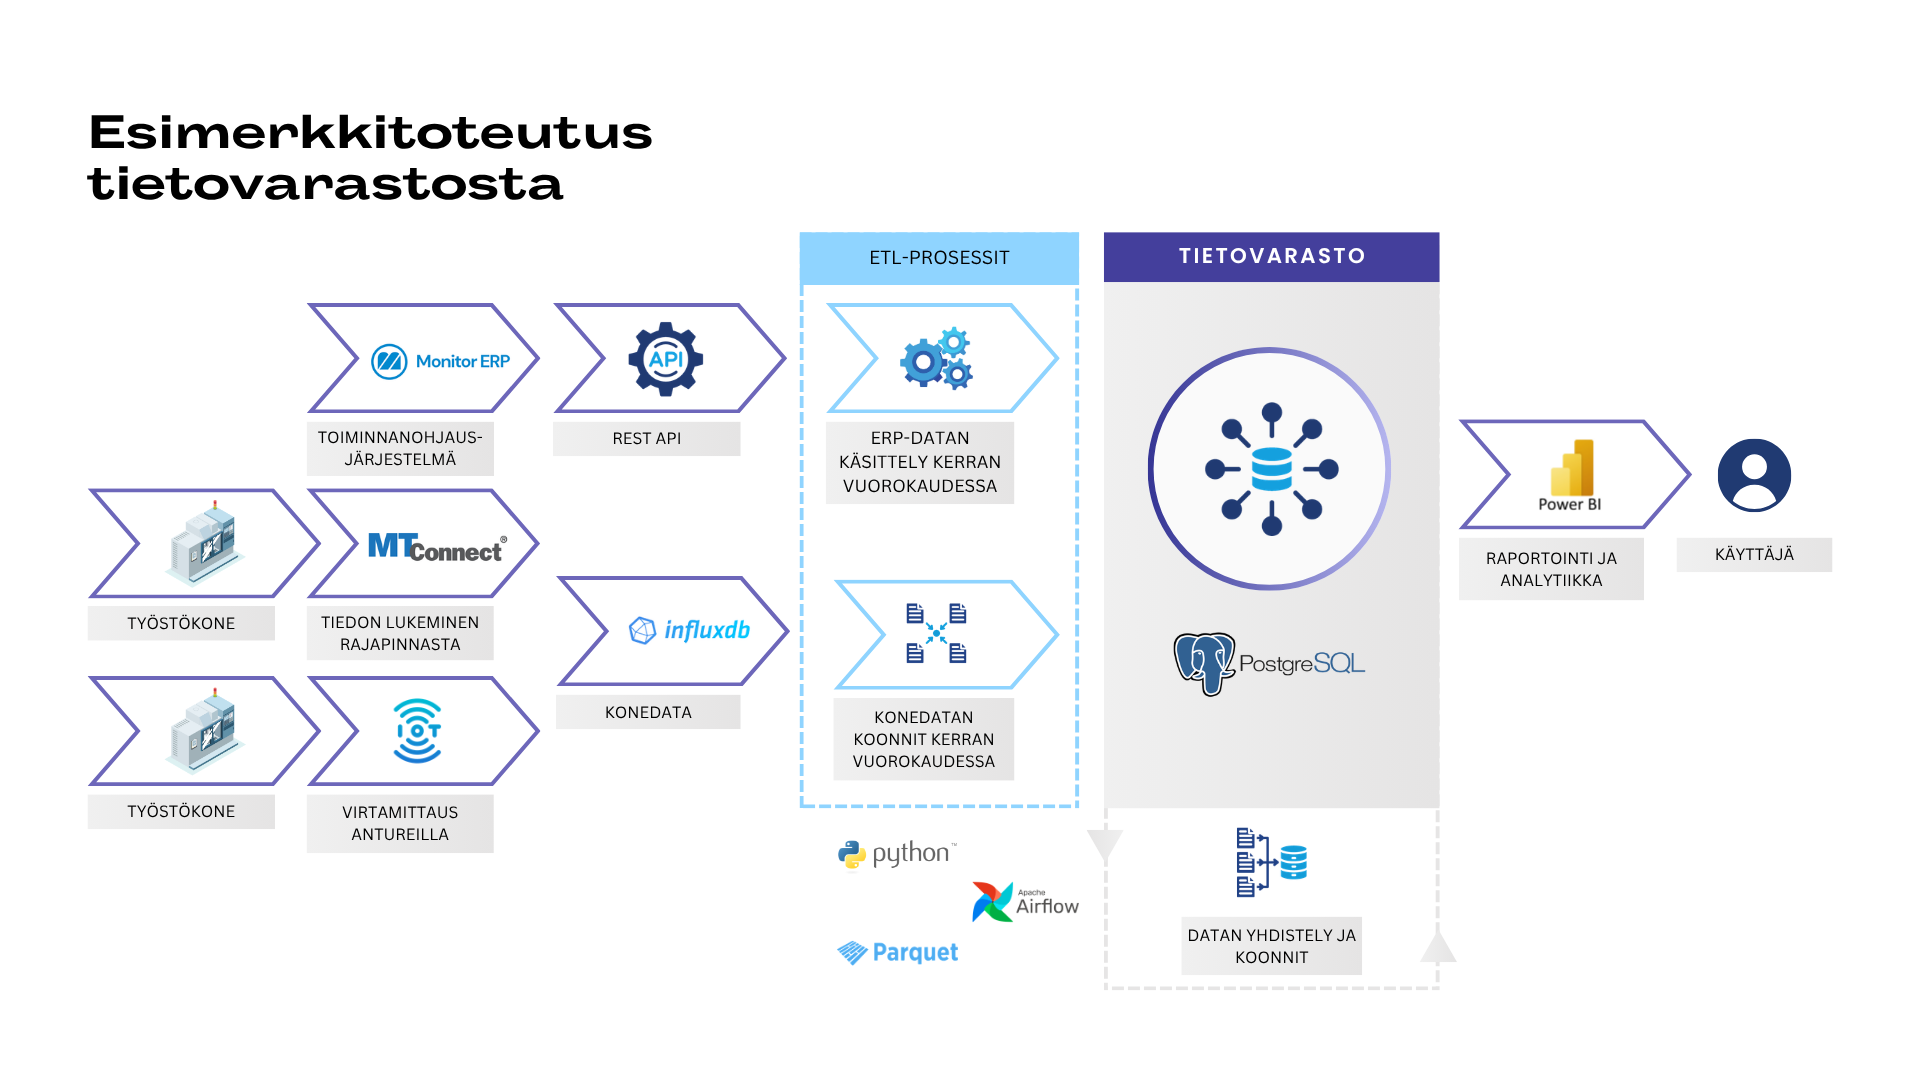
Toteutukseen liittyvän konedatakeruujärjestelmän kuvaus löytyy sivulta tuotantokoneet tietolähteinä ja julkaistut koodit Githubista.
Toteutuksessa tehtiin seuraavia valintoja:
- Tietovarasto toteutettiin yrityksen sisäverkossa olevalle virtuaalikoneelle pilvipalvelun sijaan yrityksen toiveesta. Näin pidettiin kustannukset kontrollissa ja liiketoiminnan kannalta tärkeät tiedot eivät päätyneet pilveen.
- Tietoja tuotiin tietovarastoon ERP-järjestelmästä (Monitor ERP) sekä erillisestä konedatan tietokannasta, johon kerättiin dataa muutamasta tuotantokoneesta.
- ERP-järjestelmään yhdistettiin ohjelmointirajapinnan (REST API) kautta suoran tietokantayhteyden sijaan. Tämä on monesti turvallisempi tapa ja rajapintaan löytyi dokumentaatio toisin kuin tietokannan tauluihin.
- Tietovaraston alustaksi valittiin PostgreSQL. Tavallinen relaatiotietokantaRelaatiotietokanta (Relational Database). Taulupohjainen tietokanta, jossa data järjestetään riveihin ja sarakkeisiin ja taulujen välille määritellään suhteita. on täysin riittävä kevyen tietovaraston toteutukseen.
- Konedatan tietokannaksi valittiin InfluxDB, joka soveltuu hyvin aikasarjamuotoisen datan tallennukseen. Tietovarasto ja konedatan tietokanta haluttiin pitää erillään. Vaihtoehtona olisi ollut lisätä TimescaleDB PostgreSQL-asennukseen, jolloin konedataKonedata (Machine data). Suoraan tuotantokoneilta kerätty tieto, kuten tila, nopeus tai ohjelma. Voi olla vaikka ohjelmistorajapinnan (API), logiikkapiirin tai antureiden avulla kerätty olisi voinut olla samassa tietokannassa.
- ETL-prosessin hallintaan ja ajastukseen käytettiin Apache Airflow:ta. Tietomuutokset hoitaneet Dagit kirjoitettiin Python-kielellä.
- ETL-prosessit ajastettiin ajettavaksi kerran vuorokaudessa sekä ERP-järjestelmästä että konedatan tietokannasta.
- ETL-prosessin aikana vaiheiden välitulokset tallennettiin Parquet-tiedostoina, jotka aina ylikirjoitettiin.
- Tietovarasto päätettiin päivittää joka vuorokausi kokonaisuudessaan lukuunottamatta konetapahtumien taulua. Tämä aiheuttaa melko paljon turhaakin prosessointia, mutta toisaalta inkrementaaliset tietovaraston päivitykset olisivat lisänneet toteutuksen monimutkaisuutta.
- Toteutus tehtiin Docker-kontteina helpottamaan siirtelyä testiympäristöstä tuotantoon. Toteutus olisi onnistunut myös ilman Dockeria.
- Keskeisenä haasteena ollut konedatan yhdistäminen ERP-dataan ja toteumien laskenta päätettiin tehdä jälkikäteen tietovaraston päällä erillisessä Airflow-prosessissa. Alkuperäisenä tavoitteena oli saada yhdistäminen hoidettua mahdollisimman aikaisessa vaiheessa.
Toteutustavassa on seuraavia rajoitteita:
- Toteutustapa ei juuri huomioi muuttuvia tietoja. Jos esimerkiksi työn suunniteltua aloitusajankohtaa on muokattu useampaan kertaan ERP-järjestelmässä, nämä muutokset eivät säily tietomalliin. Yksi tietovarastoinnin keskeisiä periaatteita on historiatiedon säilytys, mutta tässä toteutustavassa se ei toteudu. Historiatiedon säilytys olisi kuitenkin suhteellisen helposti lisättävissä mukaan.
- Tietovarasto ei sellaisenaan kovin hyvin sovellu vaikkapa tuotannon tilannekuvan toteutukseen. Reaaliaikaisemman tuotannon tilannekuvan toteutus kannattaa tehdä eri tavalla, mutta siinä voi hyödyntää osana konedatan tietokantaa, joka on tässä ratkaisussa erillinen.
- Mittareita ei lasketa suoraan tietoalustan päällä, vaan ne tulee määritellä erikseen vaikka BI-ohjelmassa.
- Tietovarasto ei ole sellaisenaan vielä tekoälymallien hyödynnettävissä. Tekoälymallin käyttöä varten tietovarastoon olisi hyvä liittää vaikka MCPMCP (Model Context Protocol). Rajapintamalli, jolla sovellukset ja tietovarastot voivat välittää kontekstuaalista tietoa mm. kielimalleille (LLM) niiden toiminnan ohjaamiseksi.-rajapintapalvelin ja tuoda tuoda semanttinen tieto vaikka tietomallin dokumentaatiosta.
Toteutuksesta saatiin seuraavat opit:
- Täytyy ymmärtää melko tarkasti yrityksen liiketoimintaprosessit ja tiedon kirjaustavat, että voi poimia oleellisia tietoja järjestelmistä ja ymmärtää niiden rajoitteet. Käytännössä olisi hyvä pystyä luomaan yhteys lähdejärjestelmän lomakkeiden sekä raporttien ja tietokannan elementtien välille. Oikeiden tietojen löytäminen ERP-järjestelmän tietokannasta ei ollut aivan yksinkertaista ja tiedon lähteitä jouduttiin muuttamaan usein ymmärryksen lisääntyessä.
- Koneista kerätyn datan yhdistäminenDatan yhdistäminen (Data Integration). Datan kokoaminen eri lähteistä. ERP/MES dataan onnistuu helpoiten, jos leimaukset ovat kutakuinkin kunnossa. Pelkkiin ohjelmien nimiin sekä ajankohtiin perustuva yhdistäminen on haasteellisempaa saada toimimaan luotettavasti.
- Pelkkä anturidatakin on hyvin hyödynnettävissä täydentämään leimausten tietoja. Vaikka tämän datan yhdistämistä suoraan töihin ei tehtäisikään, antaa pelkkä visuaalinen tarkastelukin hyvin lisätietoja töistä ja koneen käytöstä. Visualisoinnissa auttaa, jos samalle aikajanalle ottaa leimausten tiedot sekä anturidatasta johdetut tiedot päällekkäin.
- Osa taulujen kenttien laskennasta kannattaisi ehkä toteuttaa mieluummin tekemällä SQL-kielellä tietokannan näkymiä (view) tai materialisoituja näkymiä (materialized view). Kaikki laskennat tehtiin toteutuksessa ajastettuina Python-skripteinä, mikä ei ole kaikissa tapauksissa käytännöllisin ratkaisu.
- Monivaiheisissa tiedon muutoksissa saattaa hämärtyä tieto, mistä lähdejärjestelmän kentästä tieto on alun perin poimittu ja mitä muutoksia sille on tehty. Datan jäljitettävyys (Data Lineage) on tärkeää pitää mukana ja dokumentoituna.
- Toteutukseen käytettävillä työkaluilla ja alustoilla on loppupeleissä suhteellisen vähän merkitystä. Keskeistä on saada halutut tiedot luotettavasti lähdejärjestelmistä tietomallin mukaiseen muotoon ja tämä on toteutettavissa monilla erilaisillä lähestymistavoilla.
Esimerkkitoteutusten soveltaminen
Yllä kuvattua esimerkkitoteutusta voidaan soveltaa PK-yrityksen ensimmäisen tietovarastototeutuksen suunnittelussa. Tietovaraston toteutustapaan liittyy rajoitteita eikä se ole kovinkaan hyvä esimerkki parhaita käytäntöjä noudattavasta modernista tietovarastototeutuksesta. Siinä on kuitenkin toimivia ratkaisuja kevyempää tietovarastototeutusta varten.
Tuotantotiedon tietomalli soveltuu hyvin pohjaksi, jota voi muokata ja täydentää yrityksen omien tarpeiden ja käytössä olevien käsitteiden mukaan.
Peruslähtökohdat pysyvät samoina, vaikka toteutusta lähdettäisiin tekemään suoraan pilvipohjaiselle alustalle alustakohtaisia työkaluja hyödyntäen. Kaikki lähtee strategiasta, tietotarpeista, tietomallinnuksesta, olemassa olevien prosessien ja tietojen ymmärtämisestä ja seurattavien mittareiden määrittämisestä. Kun nämä ovat kunnossa, tietovaraston ja raporttien toteutus on pääosin tekninen haaste.
Lisätietoja toteutuksesta
Alla on linkkejä TUOVA-hankkeessa tehtyihin liittyviin julkaisuihin.
- TUOVA tuotantotiedon tietomalli: Julkaistu tietomalli tuotantotiedon tallentamiseen ja analysointiin.
- TUOVA esimerkkitoteutuksen lähdekoodit: Muut TUOVA-hankkeessa Githubiin julkaistut ETL-prosessien ja muiden toteutusten lähdekoodit dokumentaatioineen.
- Ruotsalainen, S.: Tuotantodatan hyödyntäminen tiedolla johtamisessa: tehokkaampaa johtamista analytiikan avulla: Opinnäytetyö kehitetyn tietomallin pohjalta laskettavista mittareista.
- Power BI testiraportti : Opinnäytetyönä toteutetun Power BI -esimerkkiraportin katselunäkymä.
- Havukainen, V.: Käyttökokemussuunnittelu valmistavan teollisuuden ERP-järjestelmissä : empiirinen tutkimus tehokkaiden tuotantoprosessien tukemisesta: Diplomityö koneistusyrityksen henkilöstölle tehdyistä haastatteluista.
Tekijät:
- Sivun pääkirjoittaja: Jesse Honkanen, TKI-asiantuntija, Savonia-amk
- Sisällön tarkistukseen ja täydennyksiin osallistunut muu TUOVA-hankkeen henkilöstö sekä toimituskunta.
Sisällön tuotannossa on käytetty apuna tekoälytyökaluja (mm. Copilot) kieliasun yhtenäistämisessä, käsitteiden selittämisessä, tiivistelmissä ja joidenkin osioiden kirjoittamisessa. Hankehenkilöstö on tarkistanut tekoälyn tuotokset ennen julkaisua.
TUOVA-hankkeen tekemät kuvaajat ja sarjakuvat hahmoineen on toteuttanut pääosin Emmi Paananen yhteistyössä muun hankehenkilöstön kanssa. Muualta otettujen kuvituskuvien ja kuvaajien yhteydessä on mainittu lähde.
Lisenssi: Tekstit ja hankkeen tekemät kuvat on julkaistu CC BY-SA 4.0 lisenssillä.
Sivun alkuperäinen julkaisupäivämäärä: 24.8.2026
Tällä sivulla käytiin läpi esimerkkiä tietovarastoprojektin toteutuksesta. Seuraavassa kokonaisuudessa käydään läpi tiedolla johtamisen periaatteita ja mittareita, jotka aiheina linkittyvät vahvasti tietovarastoihin.